



تقوم النماذج اللغوية التوليدية على مهمة تبدو بسيطة في ظاهرها: تقدير ما يُرجَّح أن يأتي بعد السياق الحالي. غير أن الأدق في النماذج الحديثة أن نتحدث عن التنبؤ بالرمز التالي (Next Token Prediction) لا بالكلمة التالية حرفيًا، لأن النص يُقسَّم عادة إلى وحدات تسمى Tokens، قد يكون الواحد منها كلمة كاملة، أو جزءًا من كلمة، أو علامة ترقيم، أو وحدة أخرى.
ومن هذه الفكرة الأساسية تطورت أنظمة نمذجة اللغة عبر أجيال متعاقبة: بدأت بنماذج إحصائية مثل N-gram، ثم انتقلت إلى الشبكات العصبية المتكررة RNN وLSTM، حتى وصلت إلى Transformers والنماذج اللغوية الكبيرة الحديثة.
ولم تكن القفزة الحقيقية في تغيير السؤال الأساسي، بل في طريقة تمثيل السياق: من عدّ الكلمات السابقة، إلى ضغط التاريخ داخل حالة مخفية، ثم إلى استخدام الانتباه لربط أجزاء السياق ببعضها بصورة مباشرة وأكثر قابلية للتوازي. وهذه الرحلة هي ما يتتبعه هذا المقال.
ما المقصود بالتنبؤ بالكلمة التالية؟
في أبسط الصور، إذا كان السياق «ذهب الطالب إلى ...»، فإن النموذج يحاول تقدير توزيع احتمالي للكلمة أو الرمز الذي قد يليه:
| المرشح | الاحتمال |
|---|---|
| نصوص أكاديمية | 0.42 |
| المدرسة | 0.23 |
| المنزل | 0.12 |
| كلمات أخرى | احتمالات أقل |
ثم تأتي خوارزمية توليد لتختار المخرج التالي. ورياضيًا، الهدف هو تقدير احتمال العنصر التالي بالنظر إلى العناصر السابقة:
P(x_t | x_1, x_2, ..., x_{t-1})
وبتكرار العملية عنصرًا بعد عنصر، يستطيع النموذج توليد جملة أو فقرة أو نص طويل.
لكن ثمة فرقًا جوهريًا بين النموذج وطريقة التوليد: فالنموذج ينتج توزيعًا احتماليًا، بينما تقرر استراتيجية فك الترميز (Decoding) كيف نختار من هذا التوزيع. وهذا الفرق يفسر لماذا قد يعطي النموذج نفسه إجابات شديدة الثبات مع Greedy Search، وأكثر تنوعًا مع Sampling.
لماذا نقول Next Token لا Next Word؟
قد تعمل أنظمة N-gram التقليدية فعلًا على مستوى الكلمات، لكن النماذج اللغوية الحديثة تستخدم غالبًا وحدات أصغر هي الـTokens. فقد تُخزَّن كلمة عربية كاملة رمزًا واحدًا، وقد تنقسم إلى عدة رموز بحسب الـTokenizer والمفردات التي دُرّب عليها.
ويساعد هذا التصميم النموذج على التعامل مع الكلمات النادرة والجديدة، والتصريفات المختلفة، والأسماء، واللغات المتعددة، وأجزاء الكلمات المشتركة. وتوضح مراجع Causal Language Modeling أن المهمة في النماذج التوليدية السببية هي التنبؤ بالـToken التالي في تسلسل من الـTokens، مع منع النموذج من رؤية الرموز المستقبلية أثناء التنبؤ.
ولهذا فعبارة "التنبؤ بالكلمة التالية" مفيدة للتبسيط، لكن Next Token Prediction هي الصياغة التقنية الأدق عند الحديث عن LLMs الحديثة.
من النص إلى توقع الرمز التالي
يمر النص بست مراحل متتابعة: يُقسَّم أولًا إلى رموز (Tokenization)، ثم تتحول الرموز إلى تمثيلات عددية (Embeddings)، ثم يُعالج السياق، لينتج النموذج درجات (Logits) تحولها Softmax إلى احتمالات، وأخيرًا تختار استراتيجية فك الترميز الرمز التالي.
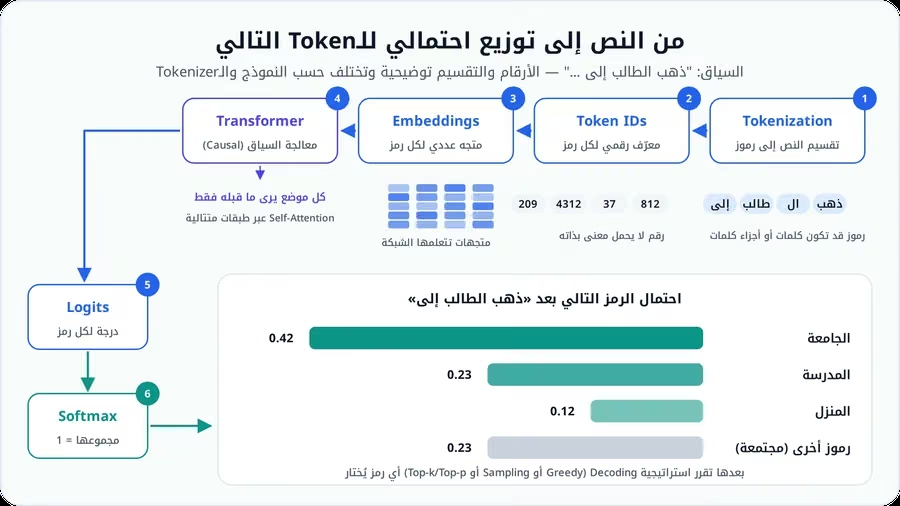
1. Tokenization: تقسيم النص إلى رموز
لا يتعامل النموذج مع الجملة الخام مباشرة، بل يبدأ بتقسيمها إلى رموز، قد تكون كلمات كاملة، أو أجزاء من كلمات، أو رموزًا شائعة، أو محارف ووحدات أصغر بحسب النظام. وقد ساعد التقسيم إلى وحدات فرعية (Subword Tokenization) مثل BPE وSentencePiece النماذج على التعامل مع المفردات الكبيرة والكلمات النادرة، دون الحاجة إلى تخزين كل كلمة محتملة عنصرًا مستقلًا. وتزداد أهمية هذه المرحلة في العربية بسبب بنيتها الصرفية والاشتقاقية الغنية، وهي نقطة سنعود إليها لاحقًا.
2. تحويل الرموز إلى أرقام
بعد التقسيم يحصل كل رمز على معرّف رقمي (Token ID). لكن رقمًا مثل 4312 لا يحمل معنى دلاليًا بذاته، فيُحوَّل إلى متجه عددي عبر طبقة Embedding.
وهنا يلزم تصحيح تبسيط شائع: ليس من الضروري أن تكون كل كلمتين متشابهتين في المعنى متقاربتين تلقائيًا في جدول الـEmbedding الأولي. فالدلالة والسياق يتشكلان عبر التدريب وطبقات النموذج، وتصبح التمثيلات السياقية داخل الشبكة أغنى بكثير من مجرد متجه أولي مستخرج من جدول (lookup vector).
3. معالجة السياق
في هذه المرحلة تختلف الأجيال الرئيسية من النماذج: فـN-gram يعتمد على التكرارات، وRNN على حالة مخفية متراكمة، وLSTM يضيف ذاكرة وبوابات، بينما يستخدم Transformer آلية Self-Attention. وهذا الاختلاف هو موضوع الأقسام التالية.
4. إنتاج الدرجات (Logits)
في النهاية ينتج النموذج درجة لكل رمز محتمل في المفردات، وتسمى هذه الدرجات Logits، وهي ليست احتمالات بعد.
5. تحويل الدرجات إلى احتمالات
تتولى دالة Softmax تحويل الدرجات إلى توزيع احتمالي يساوي مجموع عناصره 1.
6. اختيار الرمز
بعد الحصول على الاحتمالات تأتي مرحلة فك الترميز، فإما أن نختار الأعلى مباشرة، أو نحتفظ بعدة مسارات، أو نأخذ عينة احتمالية، أو نستخدم Top-k وTop-p وTemperature. فالتوليد لا ينتهي عند Softmax، وطريقة الاختيار من التوزيع جزء أساسي من سلوك النموذج النهائي.
N-gram: البداية الإحصائية
الفكرة ومثال تطبيقي
تُعد N-gram من أبسط نماذج اللغة الإحصائية، وتقوم على تقريب احتمال الكلمة الحالية بالاعتماد على عدد محدود من الكلمات السابقة بدل التاريخ الكامل. ففي نموذج Trigram يعتمد التنبؤ على آخر كلمتين.
لنفترض مجموعة نصوص صغيرة تضم أربع جمل: «أحب شرب الشاي»، و«أحب شرب القهوة»، و«أنا أحب السفر»، و«أحب شرب الشاي صباحًا». ونريد توقع ما يأتي بعد «أحب شرب ...». لقد ظهر السياق "أحب شرب" ثلاث مرات: مرتين قبل "الشاي"، ومرة قبل "القهوة". إذًا:
P(الشاي | أحب شرب) = 2/3
و:
P(القهوة | أحب شرب) = 1/3
فيختار النموذج "الشاي" إذا اعتمدنا الاحتمال الأعلى.
ما قوة N-gram؟
تكمن قوته في بساطته، وسهولة فهمه، وسرعة حسابه في النطاقات الصغيرة، واستغنائه عن الشبكات العصبية، وإمكانية تفسير سبب كل احتمال بسهولة. لكنه يعاني في المقابل من مشكلات كبيرة.
مشكلة تناثر البيانات (Data Sparsity)
إذا لم يظهر تسلسل معين في بيانات التدريب، فقد يعطي التقدير الخام بالاحتمال الأقصى (Maximum-Likelihood) احتمالات صفرية لبعض الأحداث. ولهذا استُخدمت تاريخيًا تقنيات مثل Smoothing وBackoff لتوزيع جزء من الاحتمال على الأحداث غير المرصودة. وتتفاقم المشكلة كلما زادت قيمة N، لأن عدد التركيبات الممكنة ينمو بسرعة شديدة. وفي العربية تزيد كثرة التصريفات واللواصق والصيغ عدد الأشكال السطحية للكلمات، ما قد يضاعف تناثر البيانات إذا عمل النظام على كلمات كاملة.
لماذا لا يلتقط N-gram السياق البعيد؟
لأن نموذج Trigram ينظر إلى آخر كلمتين فقط، فقد يفشل في التقاط علاقة تعتمد على كلمة ظهرت قبل عشرات الكلمات. وهذه المحدودية هي ما دفع الباحثين نحو نماذج تمثل التاريخ بصورة أكثر مرونة.
RNN: ضغط التاريخ في حالة مخفية
الحالة المخفية بدل النافذة الثابتة
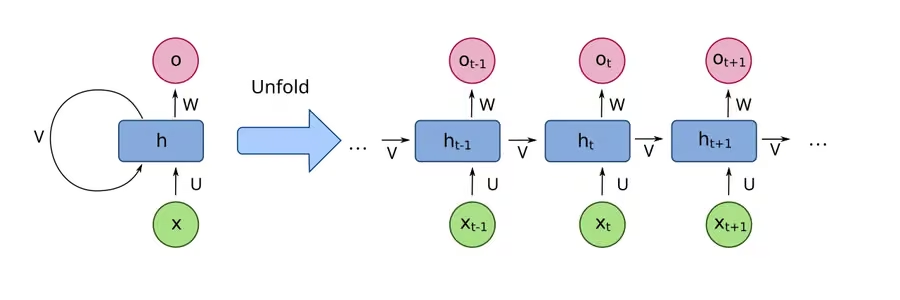
لا تعتمد الشبكة العصبية المتكررة (Recurrent Neural Network) على نافذة ثابتة من الكلمات، بل تمرر حالة مخفية (Hidden State) من خطوة إلى أخرى. ففي كل خطوة تستخدم الشبكة الرمز الحالي والحالة المخفية السابقة لتنتج حالة مخفية جديدة، وبصيغة مبسطة:
h_t = f(W_h h_{t-1} + W_x x_t + b)
وتحمل h_t تمثيلًا مضغوطًا لكل ما عالجته الشبكة حتى تلك اللحظة. ونظريًا يسمح ذلك للسياق السابق كله بالتأثير في التنبؤ، لكن الحفاظ على المعلومات البعيدة كان صعبًا عمليًا.
مشكلة تلاشي التدرج
تُدرَّب RNN عادة بخوارزمية الانتشار العكسي عبر الزمن (Backpropagation Through Time). وحين يُنشر الخطأ عبر عدد كبير من الخطوات، قد تصبح التدرجات صغيرة جدًا، فتفقد الكلمات القديمة تأثيرها في تحديث النموذج، وهو ما يُعرف بـVanishing Gradient. والنتيجة العملية أن الشبكة قد تتذكر السياق القريب جيدًا، لكنها تجد صعوبة في تعلم التبعيات البعيدة رغم أن بنيتها تسمح بها نظريًا.
LSTM: ذاكرة أطول ببوابات
ظهرت Long Short-Term Memory عام 1997 لمعالجة صعوبة تعلم الاعتماديات طويلة المدى في الشبكات المتكررة. فهي تضيف حالة خلية (Cell State) وآليات تحكم تسمى البوابات (Gates)، أشهرها بوابة النسيان (Forget Gate) وبوابة الإدخال (Input Gate) وبوابة الإخراج (Output Gate). وتساعد هذه البوابات الوحدة على تحديد ما يجب الاحتفاظ به، وما يمكن نسيانه، وما المعلومات الجديدة التي تدخل، وما الذي ينتقل إلى الحالة المخفية.
وبهذا أصبحت LSTM أقدر من RNN البسيطة على الاحتفاظ بالمعلومات المهمة لمسافات أطول. لكنها لم تحل مشكلة أخرى كبيرة: المعالجة ما تزال تسلسلية إلى حد كبير، فلا يمكن معالجة كل مواقع الجملة بالتوازي على النحو الذي أصبح ممكنًا لاحقًا مع Transformers.
Transformers: الانتباه بدل التكرار
من Encoder-Decoder إلى Decoder-only
في 2017 قدمت ورقة Attention Is All You Need معمارية Transformer، التي تخلت في تصميمها المقترح عن التكرار (recurrence) واعتمدت على الانتباه. لكن ثمة تفصيلًا مهمًا: Transformer الأصلي في الورقة كان Encoder-Decoder موجهًا أساسًا لمهام مثل الترجمة. أما النماذج التوليدية من عائلة GPT فتستخدم تصميم Decoder-only Transformer أو تصميمات مشتقة منه، مع إخفاء سببي (Causal Masking) يمنع كل موضع من رؤية الرموز المستقبلية أثناء التدريب التوليدي.
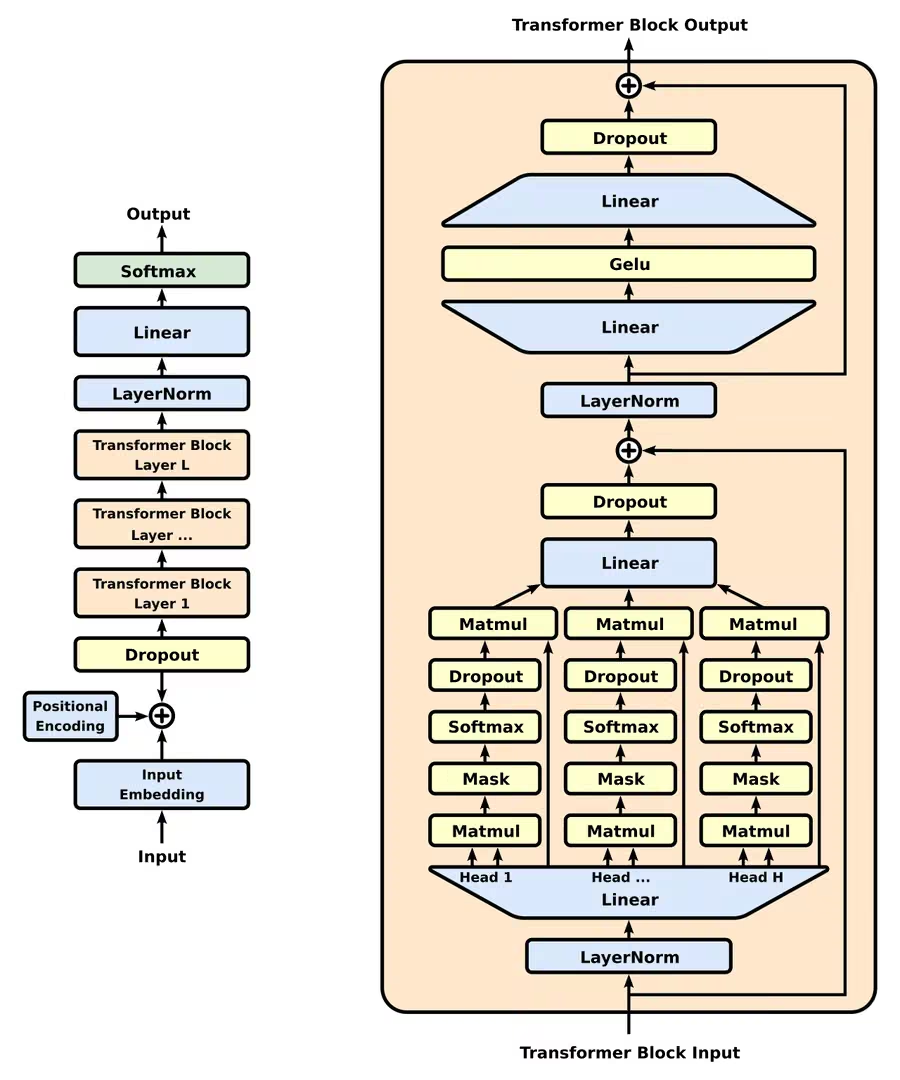
وتكتسب هذه النقطة أهميتها من أن عبارة "Transformers تتنبأ بالكلمة التالية" صحيحة في سياق النماذج السببية الحديثة، لكنها ليست وصفًا دقيقًا لكل Transformer موجود.
ما هي Self-Attention؟
بدل ضغط التاريخ كله في حالة واحدة كما تفعل RNN، تسمح Self-Attention لكل موضع بحساب علاقته بالمواضع الأخرى في السياق المسموح له برؤيته. وتنطلق الآلية من ثلاثة تمثيلات: الاستعلام Query (Q)، والمفتاح Key (K)، والقيمة Value (V). والصيغة الأساسية للـScaled Dot-Product Attention هي:
Attention(Q,K,V) = softmax(QKᵀ / √d_k) V
والفكرة المبسطة أن الاستعلام يمثل ما يبحث عنه الموضع الحالي، والمفاتيح تساعد على قياس أهمية المواضع الأخرى، والقيم تحمل المعلومات التي ستُدمج، فتحوّل Softmax درجات العلاقة إلى أوزان، وينتج النموذج مزيجًا موزونًا من المعلومات.
ما الذي يميز الانتباه السببي؟
في التوليد الذاتي الانحدار (Autoregressive Generation) لا يُسمح للرمز الحالي بالنظر إلى المستقبل. فإذا كان التسلسل «الذكاء الاصطناعي يساعد على ...»، فعند تدريب النموذج على توقع العنصر الرابع، يستطيع رؤية ما قبله فقط، لا الإجابة الصحيحة الموجودة لاحقًا في النص. ويُفرض ذلك بقناع سببي (Causal Mask)، وهي الآلية التي تجعل التدريب متوافقًا مع طريقة الاستخدام لاحقًا: توقع العنصر التالي من العناصر السابقة.
لماذا تفوقت Transformers على RNN في النماذج الكبيرة؟
لأسباب أهمها: إمكانية معالجة المواقع خلال التدريب بدرجة توازٍ أعلى من RNN، وتمثيل العلاقات البعيدة مباشرة عبر الانتباه، وقابلية التوسع إلى نماذج ضخمة وبيانات كبيرة، وقدرة Multi-Head Attention على تعلم أنواع متعددة من العلاقات، وسهولة دمجها مع تقنيات التدريب واسعة النطاق. وقد مهد هذا التطور لنماذج ذاتية الانحدار كبيرة مثل GPT وغيرها.
هل "يفهم" النموذج أم يحسب الاحتمال فقط؟
على مستوى هدف التدريب الأساسي، يتعلم النموذج تقدير احتمالات الرموز. لكن اختزال سلوك النماذج الكبيرة في عبارة "مجرد اختيار أكثر كلمة احتمالًا" غير دقيق لسببين. الأول أن النموذج يبني أثناء التدريب تمثيلات داخلية معقدة للسياق، قد تدعم مهام مثل الاستدلال والتلخيص والترجمة والإجابة عن الأسئلة. والثاني أن النموذج لا يختار دائمًا الاحتمال الأعلى؛ فطريقة فك الترميز قد تستخدم أخذ العينات، كما يتوقف سلوكه على السياق والتدريب اللاحق والمحاذاة والأدوات المستخدمة. ولذلك فالعبارة الأدق:
النموذج التوليدي ينتج توزيعًا احتماليًا للـToken التالي استنادًا إلى تمثيل متعلم للسياق، ثم تحدد استراتيجية التوليد كيف يُختار المخرج الفعلي.
الفرق بين التدريب والتوليد
هذا من أكثر مصادر الالتباس شيوعًا. أثناء التدريب يعرف النظام النص الحقيقي، ويُدرَّب على رفع احتمال الرمز الصحيح. فإذا كانت الجملة «زرت مدينة دمشق في ...» وكان العنصر الحقيقي التالي "الصيف"، تُحسب دالة خسارة (Loss) تقيس مدى ابتعاد توزيع النموذج عن الهدف، ثم تُحدَّث الأوزان بخوارزميات تحسين قائمة على Gradient Descent.
أما أثناء الاستخدام فلا توجد إجابة صحيحة معروفة مسبقًا. فيعطي النموذج توزيعًا قد يمنح "الصيف" 0.28، و"سوريا" 0.17، و"عام" 0.11، و"الشتاء" 0.09، وهكذا، ثم تحدد استراتيجية فك الترميز ما سيُختار. وبعد اختيار الرمز يُضاف إلى السياق، وتتكرر العملية من جديد.
استراتيجيات توليد النص
Greedy Search
يختار في كل خطوة الرمز الأعلى احتمالًا. وميزته أنه بسيط وثابت وسريع نسبيًا، لكنه قد ينتج نصًا متوقعًا أو مكررًا، ولا يضمن أن القرار المحلي الأفضل في كل خطوة سيقود إلى أفضل تسلسل كامل.
Beam Search
يحتفظ بعدة مسارات مرشحة بدل مسار واحد. ويُستخدم كثيرًا في مهام تسلسلية محددة، لكنه ليس الخيار الأمثل لكل أشكال الكتابة المفتوحة؛ فقد أظهرت أبحاث التوليد العصبي أن زيادة التركيز على الاحتمالية الأعلى وحدها قد تنتج نصًا أقل طبيعية في بعض مهام التوليد المفتوح.
Temperature
تعدّل Temperature شكل توزيع الاحتمالات قبل أخذ العينات: فالقيمة الأقل تجعل التوزيع أكثر حدة والنتائج أكثر تحفظًا، والقيمة الأعلى تجعله أكثر تسطحًا وتنوعًا. وليست Temperature "مقياس إبداع" بالمعنى الحرفي، بل معامل يؤثر في توزيع الاحتمالات، ومن ثم في احتمال اختيار رموز أقل ترجيحًا.
Top-k
نحتفظ بأعلى k رموز احتمالًا ثم نأخذ عينة منها؛ فإذا كانت k=50، تُستبعد كل العناصر خارج أعلى خمسين.
Top-p أو Nucleus Sampling
بدل عدد ثابت، نختار أصغر مجموعة من الرموز يبلغ مجموع احتمالاتها قيمة مثل p=0.9، فيتغير حجم مجموعة المرشحين بحسب درجة يقين النموذج.
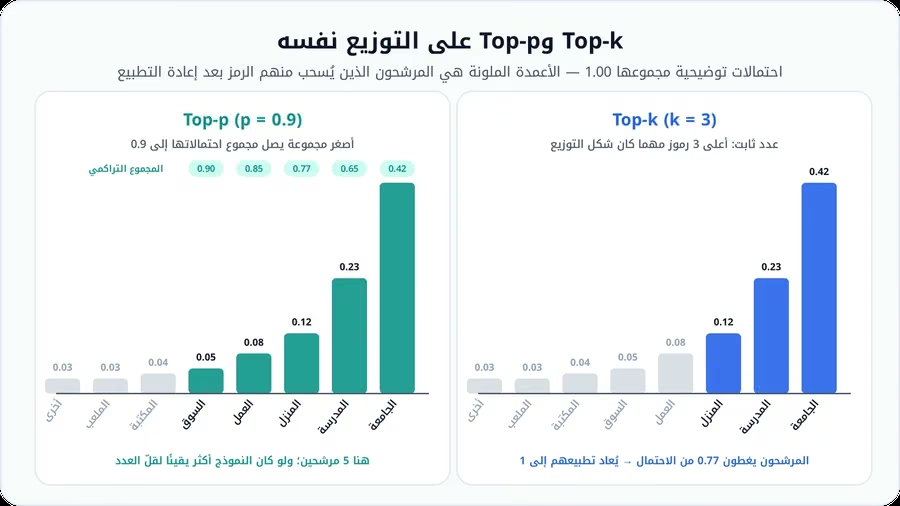
وقد اقترحت ورقة The Curious Case of Neural Text Degeneration هذا الأسلوب وسيلةً للحد من الذيل منخفض الموثوقية في التوزيع، مع الحفاظ على تنوع أكبر مما تتيحه طرق التعظيم الصارمة في التوليد المفتوح.
لماذا تمثل العربية تحديًا خاصًا؟
ليست المشكلة أن العربية "صعبة" عمومًا، بل أن لها خصائص يجب أن يتعامل معها النظام بصورة مناسبة في البيانات والترميز والتقييم.
الغنى الصرفي والاشتقاقي
قد تجمع كلمة عربية واحدة حرف عطف، وحرف جر، وأداة تعريف، وجذرًا، ووزنًا، وضمائر أو لواحق. فكلمة مثل «وبكتابهم» تحمل عدة وحدات لغوية داخل شكل كتابي واحد.
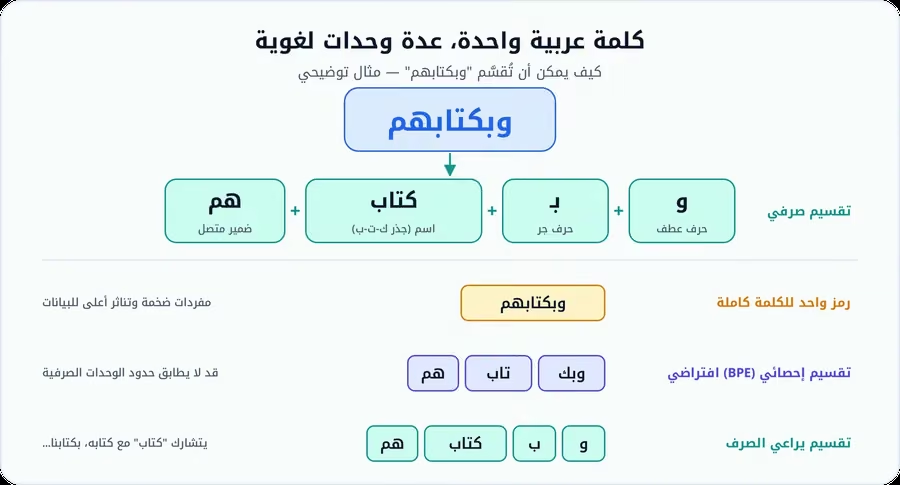
ولهذا قد يؤدي التعامل مع كل شكل سطحي وحدةً مستقلة إلى مفردات ضخمة وتناثر أعلى في البيانات، وتؤكد أبحاث Arabic NLP منذ سنوات طويلة أن التقسيم والمعالجة الصرفية جزء محوري من معالجة العربية.
الصرف غير التسلسلي
لا تقتصر العربية على السوابق واللواحق؛ فجزء مهم من صرفها يقوم على الجذر والوزن، أي أن التغييرات قد تحدث داخل بنية الكلمة نفسها. وهذا يمثل تحديًا لخوارزميات التقسيم التي تعتمد أساسًا على دمج المقاطع المتجاورة أو فصلها إحصائيًا، وقد أوضحت أبحاث 2025 حول اللغات ذات الصرف غير التسلسلي أن خوارزميات Subword التقليدية قد لا تمثل بنية الجذر والوزن بصورة طبيعية دائمًا.
غياب التشكيل في معظم النصوص
يُكتب النص العربي المعتاد غالبًا دون الحركات القصيرة، فيحتمل الشكل الكتابي الواحد أكثر من قراءة أو معنى، ويكون السياق هو ما يساعد النموذج على تضييق الاحتمالات.
الازدواجية اللغوية واللهجات
يستخدم العالم العربي العربية الفصحى الحديثة، ولهجات محلية متعددة، ومستويات وسيطة بينهما، إضافة إلى التناوب اللغوي (Code-switching) بين العربية والإنجليزية أو الفرنسية وغيرهما. وتشير الدراسات الحديثة حول Code-switched Arabic إلى أن البيئة اللغوية العربية متعددة المستويات على نحو يجعل بناء النماذج والبيانات والتقييم أعقد من التعامل مع "العربية" كتلةً واحدة متجانسة.
اختلاف الكتابة غير الرسمية
في الشبكات الاجتماعية خصوصًا نجد اختلافات إملائية، ومدًّا للحروف، وكتابة Arabizi، وكلمات أجنبية، ولهجات بلا معيار إملائي ثابت، وتناوبًا لغويًا داخل الجملة نفسها، وكلها عوامل تزيد صعوبة التقسيم والتطبيع والتنبؤ.
هل يكفي Tokenizer "صرفي" لحل مشكلة العربية؟
لا، وهذه نقطة اتضحت أكثر في أبحاث 2025 و2026. فقد بيّنت دراسات سابقة أن إضافة معلومات صرفية إلى التقسيم يمكن أن تحسن تمثيلات العربية وبعض المهام، كما قدم بحث MorphBPE في ACL 2026 نتائج تشير إلى أن التقسيم الواعي بالصرف يمكن أن يحسن الاتساق الصرفي ويخفض Language Model Cross-Entropy، مع تحسينات في فهم المقروء للعربية ضمن إعداداته التجريبية.
لكن دراسة أخرى في LREC 2026 فحصت تمثيل الجذر والوزن في سبعة نماذج وTokenizers عربية ومتعددة اللغات، ووجدت أن توافق تقسيم الـTokenizer مع البنية الصرفية ليس شرطًا ضروريًا ولا كافيًا وحده لضمان قدرة النموذج على توليد الصيغ الصرفية بصورة جيدة. والمغزى:
جودة العربية لا تتحدد بالـTokenizer وحده؛ بل تتداخل معها البيانات، وحجم النموذج، ومعمارية التدريب، وتوزيع اللهجات، وجودة التقييم، والتدريب اللاحق.
كيف تطورت النماذج العربية الحديثة؟
Jais
ظهر Jais عام 2023 عائلةً من النماذج التوليدية المتمحورة حول العربية والإنجليزية، بنموذج أساس ونسخة محادثة. وكانت النسخة الأساسية المنشورة في الورقة بحجم 13 مليار Parameter، وتعتمد معمارية Decoder-only مشتقة من GPT-3، مع تدريب على مزيج من العربية والإنجليزية والكود، ثم توسعت العائلة لاحقًا إلى أحجام وسياقات مختلفة.
Jais 2
في ديسمبر 2025 أعلنت Inception وCerebras وMBZUAI عن Jais 2، جيلًا أحدث من النماذج العربية مفتوحة الأوزان، تصفه المواد المنشورة بأنه مصمم من البداية لأداء قوي في العربية الفصحى واللهجات، مع اهتمام أكبر بالتنوع الثقافي واللغوي. وفي 2026 ظهرت ورقة تقنية تفصيلية لعائلة Jais 2 تتضمن نسخًا تصل إلى 70 مليار Parameter، مع مفردات مخصصة للعربية ومقارنات على Benchmarks عربية وثقافية.
ALLaM
ALLaM عائلة نماذج لغوية تركز على العربية والإنجليزية. وتوضح ورقتها التقنية المنشورة عام 2024 أنها تعتمد معمارية Decoder-only ذاتية الانحدار، وتتناول توسيع المفردات، والتدريب على مزيج عربي-إنجليزي، ونقل المعرفة بين اللغتين، إضافة إلى محاذاة لاحقة مع التفضيلات البشرية.
والمهم هنا ليس ترتيب Jais وALLaM بوصف أحدهما "أفضل نموذج"، بل أنهما مثالان على انتقال Arabic NLP من مجرد استخدام نماذج متعددة اللغات إلى تصميم وتدريب نماذج تتمحور حول العربية نفسها.
مقارنة بين N-gram وRNN وLSTM وTransformer
| النموذج | تمثيل السياق | أهم ميزة | أهم قيد |
|---|---|---|---|
| N-gram | آخر N−1 عناصر | بسيط وقابل للتفسير | تناثر البيانات وسياق محدود |
| RNN | Hidden State متراكمة | سياق أطول من N-gram | صعوبة التبعيات البعيدة والمعالجة التسلسلية |
| LSTM | Hidden State + Cell State + Gates | ذاكرة أفضل للعلاقات الطويلة | ما تزال تسلسلية نسبيًا |
| Transformer | Self-Attention | علاقات مباشرة وتوازٍ أفضل وقابلية للتوسع | كلفة Attention التقليدية ترتفع مع طول السياق |
| Decoder-only LLM | Causal Self-Attention + تدريب واسع | توليد نصي واسع القدرات | تكلفة تدريب/تشغيل، جودة البيانات، الهلوسة، القيود السياقية |
هل يكفي التنبؤ بالرمز التالي لبناء نموذج لغوي متقدم؟
التدريب على Next Token Prediction أساس بالغ الأهمية للنماذج التوليدية ذاتية الانحدار، لكنه ليس القصة كاملة. فالنماذج الحديثة قد تمر أيضًا بمراحل مثل التدريب المسبق (Pretraining)، والضبط على التعليمات (Instruction Tuning)، والضبط الدقيق الإشرافي (Supervised Fine-Tuning)، وتحسين التفضيلات (Preference Optimization) أو أساليب محاذاة أخرى، والتدريب على استخدام الأدوات، وضبط السلامة، والتكييف مع مجالات محددة.
ولذلك فالنموذج الذي يستخدمه المستخدم النهائي ليس عادة مجرد شبكة انتهى تدريبها عند توقع الرمز التالي على نص خام. ومع ذلك تبقى مهمة التنبؤ بالعنصر التالي المحرك الحسابي الأساسي للتوليد خطوة بخطوة في عدد كبير من النماذج اللغوية الحديثة.
ويمكن للتطبيقات أيضًا أن تضيّق طريقة استخدام هذا المحرك: ففي مشروع تطبيق دليل الطالب الجامعي الرقمي يُستخدم Gemini لفهم نية السؤال ومطابقته مع قاعدة أسئلة شائعة مضبوطة فقط، لا لتوليد إجابات مفتوحة.
أخطاء شائعة في فهم التنبؤ بالكلمة التالية
| المقولة الشائعة | التصويب |
|---|---|
| "النموذج يبحث عن الكلمة الأكثر استخدامًا" | ليس بالضرورة؛ N-gram البسيط يعتمد بشدة على التكرار، لكن Transformer الحديث ينتج الاحتمالات اعتمادًا على تمثيل معقد للسياق تعلمه من التدريب |
| "كل Token هو كلمة" | خطأ؛ قد يكون الرمز جزءًا من كلمة أو علامة أو وحدة أخرى |
| "Transformer يرى كل الجملة المستقبلية عند التوليد" | في Causal Language Models لا يرى المستقبل، إذ يمنع القناع السببي ذلك |
| "أعلى احتمال دائمًا يعطي أفضل نص" | ليس بالضرورة؛ Greedy decoding قد يختلف كثيرًا عن Sampling، وقد أظهرت الأبحاث أن تعظيم الاحتمال وحده ليس دائمًا أفضل استراتيجية للتوليد المفتوح |
| "Tokenizer صرفي = نموذج عربي ممتاز" | غير كافٍ؛ التقسيم مهم، لكن جودة النموذج تعتمد على منظومة كاملة تشمل البيانات والتدريب والمعمارية والتقييم |
| "النماذج الحديثة تتنبأ بكلمة واحدة ثم تتوقف" | لا؛ يُضاف الرمز المختار إلى السياق ثم تُعاد العملية مرارًا حتى يبلغ النموذج شرط التوقف أو الحد الأقصى للتوليد |
ما مستقبل التنبؤ النصي في العربية؟
لا يبدو اتجاه التطور محصورًا في زيادة عدد المعاملات. فثمة محاور عدة تتقدم معًا: تقسيم أكثر كفاءة للعربية، وتمثيل أفضل للصرف والجذور والأوزان، وبيانات لهجية أعلى جودة، ومعالجة التناوب اللغوي، ونماذج عربية مفتوحة الأوزان، وسياقات أطول وأكثر كفاءة، وتقنيات انتباه أكفأ، وتقييمات عربية وثقافية أفضل، وتقليل الهلوسة وتحسين الإسناد إلى المصادر (Grounding)، ودمج الأدوات والاسترجاع الخارجي (مثل استخدام معيار بروتوكول MCP)، ونماذج أصغر وأكفأ للاستخدام المحلي والأجهزة الطرفية.
وتؤكد الأبحاث الحديثة حول Morphology-Aware Tokenization أن المسألة لم تُحسم بعد؛ فهناك تقدم واضح، لكن العلاقة بين شكل الرموز والقدرة اللغوية الفعلية أعقد من أن تختزلها قاعدة واحدة بسيطة.
الخلاصة
بدأ التنبؤ بالكلمة التالية مسألةً إحصائية بسيطة نسبيًا: عدّ ما يأتي عادة بعد سياق قصير. فكان السياق مع N-gram نافذة محدودة، ثم أصبح التاريخ مع RNN يُضغط في حالة مخفية، ثم جاءت LSTM لتجعل الاحتفاظ بالمعلومات البعيدة أكثر استقرارًا. أما Transformers فنقلت الفكرة إلى مستوى مختلف بالانتباه والمعالجة السياقية القابلة للتوسع، وأصبحت Decoder-only Transformers أساسًا لعدد كبير من النماذج اللغوية التوليدية الحديثة.
لكن المصطلح الأدق اليوم هو غالبًا Next Token Prediction، لأن النموذج لا يتعامل بالضرورة مع كلمات كاملة. وبالنسبة إلى العربية، لا تتوقف المشكلة عند ترجمة نموذج إنجليزي أو إضافة كلمات عربية إلى المفردات؛ فالصرف، واللهجات، والتشكيل، والكتابة غير الرسمية، والتناوب اللغوي، وطريقة التقسيم، كلها عناصر تؤثر في كفاءة النموذج.
ولهذا فإن فهم "كيف يختار النموذج العنصر التالي؟" ليس مجرد شرح لخوارزمية صغيرة، بل مدخل لفهم الطريقة التي تولّد بها النماذج اللغوية الحديثة النص خطوة بخطوة.
المصادر والمراجع
- Vaswani et al. (2017), Attention Is All You Need — https://arxiv.org/abs/1706.03762
- Hochreiter & Schmidhuber (1997), Long Short-Term Memory — https://doi.org/10.1162/neco.1997.9.8.1735
- Hugging Face, Causal Language Modeling — https://huggingface.co/docs/transformers/tasks/language_modeling
- Sennrich, Haddow & Birch (2016), Neural Machine Translation of Rare Words with Subword Units — https://aclanthology.org/P16-1162/
- Kudo & Richardson (2018), SentencePiece — https://arxiv.org/abs/1808.06226
- Holtzman et al. (2020), The Curious Case of Neural Text Degeneration — https://arxiv.org/abs/1904.09751
- Habash & Rambow (2005), Arabic Tokenization, POS Tagging and Morphological Disambiguation — https://aclanthology.org/P05-1071/
- Alkaoud & Syed (2020), On the Importance of Tokenization in Arabic Embedding Models — https://aclanthology.org/2020.wanlp-1.11/
- Gazit et al. (2025), Splintering Nonconcatenative Languages for Better Tokenization — https://aclanthology.org/2025.findings-acl.1151/
- Asgari et al. (2026), MorphBPE: Morphology-Aware Tokenization for Efficient LLM Training — https://aclanthology.org/2026.findings-acl.2068/
- Alakeel et al. (2026), Morphemes without Borders — https://aclanthology.org/2026.lrec-1.923/
- Hamed et al. (2025), A Survey of Code-switched Arabic NLP — https://aclanthology.org/2025.coling-main.307/
- Sengupta et al. (2023), Jais and Jais-chat — https://arxiv.org/abs/2308.16149
- MBZUAI (2025), Release of Jais 2 — https://mbzuai.ac.ae/news-events/news/inception-cerebras-mbzuai-release-jais-2-the-next-generation-the-worlds-leading
- Anwar et al. (2026), Jais 2 — https://arxiv.org/abs/2608.13580
- Bari et al. (2024), ALLaM — https://arxiv.org/abs/2407.15390
الأسئلة الشائعة حول المقال
ما الفرق بين Next Word Prediction وNext Token Prediction؟
Next Word Prediction يفترض التنبؤ بكلمة كاملة، بينما Next Token Prediction يتعامل مع وحدات يحددها الـTokenizer وقد تكون كلمة أو جزءًا منها. في معظم النماذج اللغوية التوليدية الحديثة، Next Token Prediction هي الصياغة الأدق.
هل النماذج اللغوية تختار دائمًا الكلمة الأكثر احتمالًا؟
لا. النموذج ينتج توزيعًا احتماليًا للـToken التالي، ويمكن أن تستخدم مرحلة التوليد استراتيجيات مثل Sampling وTemperature وTop-p بدل اختيار الاحتمال الأعلى دائمًا.
لماذا لم تعد N-gram كافية للنماذج الحديثة؟
لأنها تعتمد على نافذة سياق محدودة وتعاني من Data Sparsity، ولا تستطيع تمثيل العلاقات البعيدة والمعنى بالسعة التي توفرها النماذج العصبية الحديثة.
ما الذي حلته LSTM مقارنة بـRNN؟
حسّنت LSTM التحكم في انتقال المعلومات عبر الزمن باستخدام Cell State وGates، ما ساعد على تعلم تبعيات أطول وتقليل أثر تلاشي التدرج مقارنةً بـRNN التقليدية.
لماذا Transformers مهمة للنماذج اللغوية؟
لأن Self-Attention تسمح بتمثيل العلاقات بين عناصر السياق بصورة مباشرة وتوفر قابلية أكبر للتوازي والتوسع من الشبكات المتكررة التقليدية.
ما الفرق بين Transformer وGPT؟
Transformer اسم لمعمارية عامة ظهرت أصلًا كـEncoder-Decoder. أما GPT-style models فتستخدم عادةً Transformer decoder-only مع Causal Attention للتوليد الذاتي.
لماذا اللغة العربية تحتاج اهتمامًا خاصًا في Tokenization؟
لأنها غنية صرفيًا، وتستخدم نظام الجذر والوزن واللواصق، إضافة إلى اللهجات وغياب التشكيل غالبًا وCode-switching، ما يجعل تقسيم النص وتمثيله أكثر تعقيدًا.
هل Jais وALLaM يعملان على التنبؤ بالـToken التالي؟
كلاهما ينتمي إلى النماذج اللغوية التوليدية autoregressive decoder-only، وبالتالي تعتمد عملية التوليد الأساسية فيهما على التنبؤ بالـToken التالي، مع مراحل تدريب ومحاذاة إضافية بحسب النموذج.
لماذا يقال إن النماذج اللغوية تتنبأ بالـToken التالي لا بالكلمة؟
لأن النماذج اللغوية الحديثة تقسم النص إلى وحدات تسمى Tokens عبر Tokenizer، وقد يكون الـToken كلمة كاملة أو جزءًا من كلمة أو علامة ترقيم. ويساعد التقسيم إلى Subwords بأساليب مثل BPE وSentencePiece على التعامل مع الكلمات النادرة والجديدة والتصريفات واللغات المتعددة. لذلك فعبارة التنبؤ بالكلمة التالية تبسيط مفيد، لكن Next Token Prediction هي الصياغة التقنية الأدق.
كيف يحسب نموذج N-gram احتمال الكلمة التالية؟
يعد نموذج N-gram مرات ظهور الكلمات بعد سياق قصير في بيانات التدريب. ففي نموذج Trigram، إذا ظهر السياق «أحب شرب» ثلاث مرات، مرتين قبل «الشاي» ومرة قبل «القهوة»، يكون احتمال الشاي 2/3 والقهوة 1/3. وهو بسيط وسهل التفسير، لكنه يعاني من Data Sparsity عند ظهور تسلسلات لم ترد في البيانات، ولا يلتقط السياق البعيد.
النقاش الهندسي والملاحظات (0)
سجّل الدخول للمشاركة في النقاش والرد على التعليقات والإعجاب بها.


