



يمكن استخدام الكاميرا لتحليل أنماط الحركة والتعبير في الوجه، ثم تحويلها إلى تقديرات احتمالية تُضاف إلى أنظمة التوصية بوصفها إشارة سياقية تساعد على تخصيص المحتوى. لكن من الضروري التفريق بين تحليل تعبير الوجه ومعرفة المشاعر الداخلية الحقيقية؛ فالصورة لا تمنح النظام وصولًا مباشرًا إلى ما يشعر به الإنسان.
هذا الفرق هو الأساس الذي يجب أن تُبنى عليه أي منظومة تجمع بين الرؤية الحاسوبية والحوسبة العاطفية وأنظمة التوصية. فالنظام قد يرصد نمطًا يشبه تعبيرات صُنّفت في بيانات التدريب على أنها "سعادة" أو "حزن" أو "دهشة"، لكنه في الواقع ينتج تقديرًا احتماليًا استنادًا إلى بيانات ونموذج، لا تشخيصًا نهائيًا للحالة النفسية. ثم يمكن استخدام هذا التقدير إلى جانب معلومات أخرى، مثل سجل الاستخدام وتفضيلات المستخدم والسياق الحالي، لاختيار محتوى أكثر ملاءمة.
الفكرة الأساسية للنظام
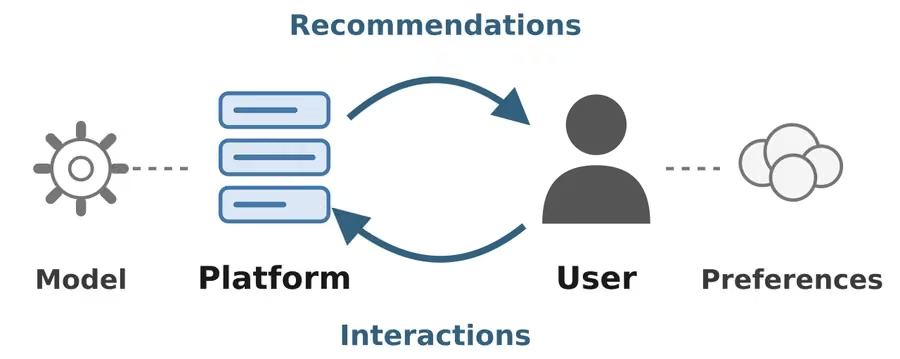
تبدأ السلسلة بالكاميرا، ثم اكتشاف الوجه وتحليل تعبيره، لينتج تقدير احتمالي يُدمج مع سياق المستخدم ويُمرَّر إلى محرك التوصية، فيقترح محتوى، وتعود تفاعلات المستخدم معه تغذية راجعة تحسّن الجولة التالية.
فقد يلتقط النظام مثلًا أنماطًا في الوجه يمنحها النموذج الدرجات التالية:
| الفئة التعبيرية | الدرجة |
|---|---|
| Neutral | 0.46 |
| Sad-like expression | 0.27 |
| Happy-like expression | 0.15 |
| Other expressions | 0.12 |
والخطأ الشائع هنا تحويل النتيجة مباشرة إلى قاعدة من نوع «المستخدم حزين، إذًا اعرض له موسيقى سعيدة». أما محرك التوصية الأكثر نضجًا فيتعامل معها بوصفها إشارة واحدة بين إشارات، فيقرأها على نحو: «ظهر نمط تعبيري يميل إلى الفئة X بدرجة ثقة محدودة، وسجل المستخدم يشير إلى تفضيل Y، والسياق الحالي Z»، ثم يرتب العناصر المرشحة بناءً على هذه البيانات كلها. وهذه المقاربة أقرب إلى الواقع بكثير من نظام يربط كل تعبير بمحتوى ثابت.
هل تستطيع الكاميرا كشف "المشاعر الداخلية"؟
لا يمكن اعتبار الوجه وحده نافذة يقينية إلى الحالة العاطفية الداخلية. وتكتسب هذه النقطة أهميتها من أن جزءًا كبيرًا من أنظمة Facial Emotion Recognition التاريخية دُرّب على صور أو فيديوهات تحمل تسميات مثل Happy وSad وAngry وFear وDisgust وSurprise وNeutral. لكن وجود هذه التسميات في Dataset لا يعني أن كل ابتسامة في العالم الحقيقي تساوي "سعادة" بصورة مؤكدة.
فقد خلصت مراجعة علمية واسعة نُشرت عام 2019 في Psychological Science in the Public Interest إلى أن العلاقة بين أنماط حركة الوجه والعواطف أكثر تنوعًا واعتمادًا على السياق والثقافة مما تفترضه النظرة المبسطة التي تربط كل تعبير بعاطفة واحدة. كما أظهرت دراسة في Nature Communications عام 2024 أن المعلومات المستقاة من الموقف والسياق قد تكون مساوية للوجه المعزول، بل أفضل منه أحيانًا، عند استنتاج الحالات العاطفية.
ولهذا سيستخدم هذا المقال تعبيرات مثل "تحليل تعبير الوجه" و"تقدير فئة تعبيرية" و"استنتاج عاطفي احتمالي"، بدل الادعاء بأن الكاميرا "تقرأ المشاعر الداخلية".
التعرف على الوجه وتحليل التعبير: مهمتان مختلفتان
كثيرًا ما تختلط مهمتان متمايزتان تمامًا:
| المهمة | السؤال الذي تجيب عنه | علاقتها بالهوية |
|---|---|---|
| Face Recognition | من هو هذا الشخص؟ | تعتمد على مطابقة هوية الوجه |
| Facial Expression Recognition أو Analysis | ما نمط الحركة أو التعبير الظاهر على الوجه؟ | لا تحتاج بالضرورة إلى معرفة هوية الشخص |
فيمكن بناء نظام يحلل تعبير الوجه دون أن يحاول تحديد اسم صاحبه. وهذا الفصل مهم من منظوري التصميم والخصوصية معًا: فإذا كان النظام لا يحتاج إلى معرفة الهوية، فلا ينبغي إضافة Facial Identification بلا ضرورة.
كيف تعمل مرحلة تحليل الوجه؟
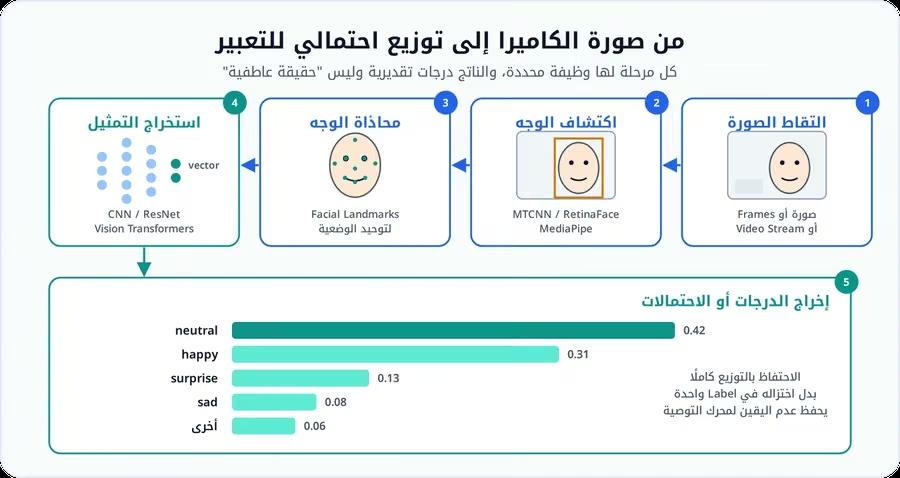
التقاط الصورة أو الفيديو
توفر الكاميرا صورة واحدة، أو سلسلة إطارات (Frames)، أو بثًا مرئيًا مستمرًا. والفيديو قد يحمل معلومات زمنية لا تظهر في الصورة الثابتة، مثل سرعة تغير التعبير.
اكتشاف الوجه
يحدد النظام موقع الوجه داخل المشهد، مستعينًا بنماذج وتقنيات مثل MTCNN وRetinaFace والمسارات القائمة على MediaPipe ونماذج الكشف الحديثة. وهذه المرحلة لا تحدد العاطفة؛ وظيفتها تحديد منطقة الوجه فقط.
محاذاة الوجه
قد يكون الوجه مائلًا، أو بعيدًا، أو قريبًا، أو ملتفتًا. لذلك تُستخدم المعالم الوجهية (Facial Landmarks) لتقدير مواضع العينين والأنف وزوايا الفم وحدود الوجه، ثم تُستثمر هذه المعلومات في محاذاة الصورة وتوحيدها قبل التحليل.
استخراج التمثيل البصري
اعتمدت الطرق التقليدية على ميزات مثل Local Binary Patterns (LBP) ومرشحات Gabor وهندسة المعالم الوجهية. أما النماذج الحديثة فتعتمد أكثر على التعلم العميق، عبر CNN والـBackbones الشبيهة بـResNet وVision Transformers والمعماريات الهجينة بين CNN وTransformer. وبدل أن يحدد المهندس كل ميزة يدويًا، يتعلم النموذج تمثيلاته من بيانات التدريب.
إخراج الدرجات أو الاحتمالات
في النهاية ينتج النموذج درجات مرتبطة بالفئات التي تدرب عليها، والأفضل الاحتفاظ بالتوزيع الاحتمالي كاملًا بدل اختزاله فورًا في تسمية واحدة، كأن يكون الناتج [neutral: 0.42, happy: 0.31, surprise: 0.13, sad: 0.08, ...]. فهذا يحافظ على جزء من عدم اليقين الذي سيحتاجه محرك التوصية لاحقًا.
FACS: هل تتحول حركة الوجه إلى عاطفة؟
Facial Action Coding System (FACS) نظام طوره Paul Ekman وWallace Friesen لوصف حركات الوجه وصفًا منهجيًا، بتقسيمها إلى وحدات تسمى Action Units (AUs)؛ فـAU12 مثلًا يرتبط برفع زوايا الفم، وAU4 يصف حركة معينة في الحاجبين.
لكن FACS يصف الحركة الوجهية لا أكثر. والانتقال من «اكتشفنا AU معينة» إلى «إذًا هذا الشخص يشعر بعاطفة X» مرحلة استدلال إضافية، لا خاصية تلقائية في FACS. ولذلك قد تكون Action Units مفيدة بوصفها ميزات (Features)، لكن لا يجوز التعامل معها دليلًا نفسيًا قاطعًا.
قواعد البيانات: ما يتعلمه النموذج يحدده ما رآه
تؤدي مجموعات البيانات دورًا حاسمًا في رسم أداء النظام وحدوده، ولكل منها طابع يترك أثره في النموذج.
FER2013
أُنشئت FER2013 ضمن تحدٍّ في مؤتمر ICML عام 2013، وتضم 35,887 صورة وجه حُولت إلى صور رمادية بدقة 48×48 وصُنفت في سبع فئات واسعة. وهي مهمة تاريخيًا، لكن صورها جُمعت من الويب بكلمات بحث مرتبطة بالعاطفة، ما يعني أن التسميات وطريقة الجمع نفسها تؤثر في ما يتعلمه النموذج.
CK+
أما Extended Cohn-Kanade، أو CK+، فأكثر انضباطًا مخبريًا، إذ تضم 593 سلسلة فيديو من 123 شخصًا، تبدأ عادة من حالة محايدة وتنتهي عند ذروة تعبير مقصود، ومن بينها 327 سلسلة تحمل تسميات لفئات تعبيرية. وهذا يجعلها مفيدة للبحث، لكنها لا تشبه تمامًا البيئة اليومية الطبيعية التي تتبدل فيها الإضاءة والسياقات والتعبيرات.
AffectNet
صُممت AffectNet لبيئات أكثر واقعية، فجمع المشروع أكثر من مليون صورة وجه من الإنترنت، ووُسم جزء كبير منها بشريًا بفئات تعبيرية وقياسات Valence/Arousal. وميزتها أنها أكثر تنوعًا من قواعد البيانات المخبرية، لكن البيانات الواقعية تحمل بدورها ضوضاء وغموضًا واختلالًا بين الفئات.
RAF-DB
تضم RAF-DB 29,672 صورة واقعية جُمعت للتعرف على التعبيرات في الظروف الطبيعية، بوسم جماعي يشمل فئات أساسية ومركبة. وتُظهر أبحاث RAF-DB نفسها أن التعبيرات الواقعية أكثر تنوعًا من التعبيرات النمطية في مجموعات البيانات المخبرية.
لماذا لا تكفي دقة Dataset واحدة؟
لأن السؤال لا يقتصر على «كم حقق النموذج على مجموعة الاختبار؟»، بل يمتد إلى أسئلة أخرى: هل تشبه بيانات الاختبار البيئة الحقيقية؟ هل تمثل الوجوه جميع المستخدمين؟ هل الصور مؤداة (Posed) أم تلقائية (Spontaneous)؟ هل الإضاءة والكاميرا متشابهتان؟ كيف وُضعت التسميات؟ هل الفئات متوازنة؟ وهل يعمل النموذج في ثقافات وبيئات أخرى؟ ولهذا يجب إجراء Cross-dataset وReal-world Validation قبل الاعتماد على النظام.
من نتيجة الوجه إلى توصية المحتوى
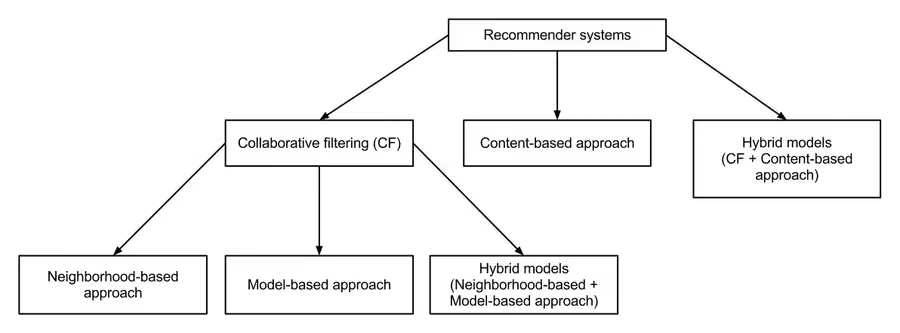
هنا ننتقل من الرؤية الحاسوبية إلى أنظمة التوصية، التي تعتمد تقليديًا على ثلاث مقاربات.
الترشيح القائم على المحتوى (Content-Based Filtering)
يقترح عناصر مشابهة لما فضّله المستخدم سابقًا؛ فإذا قرأ عدة مقالات عن الذكاء الاصطناعي، يمكن اقتراح مقالات قريبة منها.
الترشيح التعاوني (Collaborative Filtering)
يعتمد على أنماط المستخدمين الآخرين: فالمستخدمون الذين أحبوا A وB أحبوا أيضًا C، إذًا قد يعجبك C.
التوصية الهجينة (Hybrid Recommendation)
تدمج أكثر من مصدر. وفي النظام الواعي بالسياق يمكن إضافة التعبير المقدَّر إلى عوامل أخرى مثل تاريخ الاستخدام، والوقت، والجهاز، والموقع العام إن كان استخدامه مشروعًا ومسموحًا، وسلوك الجلسة، والهدف الحالي، والتغذية الراجعة الصريحة. فتصبح الإشارة العاطفية Feature إضافية داخل النموذج، لا مصدر القرار الوحيد.
قواعد ثابتة أم نموذج توصية متعلم؟
مشكلات النظام القائم على القواعد
يمكن بناء نسخة بسيطة بالقواعد: تعبير يشبه الحزن يقود إلى محتوى مُبهج، وتعبير يشبه السعادة يقود إلى محتوى نشيط، والحياد يعيد النظام إلى التفضيلات التاريخية. لكن هذا التصميم يعاني من مشكلات واضحة: فهو يفترض أن كل شخص يريد تعديل مزاجه بالطريقة نفسها، ولا يعرف إن كان المستخدم يريد مجاراة مزاجه (Mood Congruence) أم إصلاحه (Mood Repair)، ويبالغ في الثقة بتصنيف الوجه، ويكرر المحتوى نفسه، ويتجاهل تاريخ المستخدم.
خمس مراحل منفصلة
الأفضل عادة فصل المراحل بعضها عن بعض:
| المرحلة | ما تقوم به |
|---|---|
| Expression Estimation | تنتج توزيعًا احتماليًا للتعبير |
| Context Layer | تضيف تاريخ المستخدم وبيانات الجلسة والتفضيلات الصريحة والسياق الحالي |
| Candidate Generation | تولّد مجموعة محتوى مرشحة |
| Ranking | ترتب العناصر بناءً على درجة متعددة العوامل |
| Feedback | يتعلم النظام من النقرات والتخطي والإعجاب وعدمه ومدة المشاهدة والتغذية الراجعة الصريحة عن المزاج وإغلاق التوصية |
وقد تكون صيغة الترتيب المفاهيمية من نوع Score = Preference + Context + ExpressionSignal + ItemQuality + Diversity - Risk، على ألا تُعامل معادلةً عالمية، بل مثالًا على طريقة التفكير. أما مرحلة التغذية الراجعة فهي أكثر موثوقية من إعادة تحليل الوجه باستمرار دون حاجة.
هل يحسّن التعبير الحالي التوصيات فعلًا؟
تُظهر بعض الأبحاث أن دمج المعلومات العاطفية أو الوجدانية قد يحسّن أنظمة توصية معينة في نطاقات محددة. فدراسة في Expert Systems with Applications طورت نموذج توصية عاطفيًا للموسيقى، ووجدت ضمن إعدادها التجريبي أن دمج Affective Profile حسّن دقة التوصيات مقارنة ببعض الـBaselines التي لا تستخدم المعلومات العاطفية.
لكن لهذه النتيجة حدودًا يجب فهمها: فهي لا تعني أن أي كاميرا سترفع دقة التوصيات، ولا أن تعبير الوجه أفضل طريقة للحصول على الحالة الوجدانية، وقد يكون التقرير الذاتي (Self-report) أو سلوك الجلسة أرخص وأدق في حالات معينة. فالسؤال العملي يجب أن يكون:
هل إضافة هذه الإشارة تحسن المنظومة عند هذا الجمهور وهذه المهمة بما يبرر تكلفتها ومخاطرها؟
Mood Congruence أم Mood Repair؟
عند تصميم الربط بين الحالة والمحتوى (Content Mapping) يبرز اتجاهان شائعان. الأول Mood Congruence، أي اقتراح محتوى يتوافق مع الحالة الحالية، كموسيقى هادئة حين تظهر إشارات إلى حالة هادئة. والثاني Mood Repair أو Regulation، أي اقتراح محتوى يهدف إلى تغيير الحالة، كمحتوى مهدئ عند وجود مؤشرات إلى التوتر.
لكن لا ينبغي للنظام أن يقرر تلقائيًا ما يجب أن يشعر به المستخدم. فالأفضل أن يحدد المستخدم هدفه بنفسه، فيطلب مثلًا «اقترح لي شيئًا يطابق مزاجي» أو «أريد شيئًا يساعدني على الاسترخاء». وبذلك يتحول الربط من محاولة نفسية ضمنية إلى تفضيل صريح يتحكم فيه المستخدم.
لماذا التغذية الراجعة الصريحة مهمة؟
إذا كان الهدف معرفة مزاج المستخدم، فقد يكون سؤال بسيط مثل «شو مزاجك اليوم؟» أوضح وأقل تدخلًا وأقل تكلفة وأكثر احترامًا للخصوصية من كاميرا تراقب وجهه.
ويمكن تصميم مقاربة هجينة متدرجة: تبدأ بخيار مزاج اختياري، ثم بيانات الاستخدام، ثم إشارة التعبير من الكاميرا فقط حين يوافق المستخدم ويوجد سبب حقيقي، مع إمكانية تعطيل الميزة في أي وقت. وتنسجم هذه المقاربة مع مبدأ Data Minimization: لا تجمع بيانات حساسة إذا كان الهدف قابلًا للتحقيق بطريقة أبسط.
أبرز المشكلات التقنية
تتعدد مصادر الخطأ في تحليل تعبير الوجه، ويجمعها الجدول التالي:
| المشكلة | أثرها |
|---|---|
| الإضاءة | الإضاءة الضعيفة أو الظلال قد تغير الميزات التي يراها النموذج |
| زاوية الرأس | التفاف الوجه قد يخفي أجزاء مهمة |
| Occlusion | النظارات أو الكمامة أو اليد على الوجه أو الشعر تحجب أجزاء منه |
| جودة الكاميرا | الدقة ومعدل الإطارات والضغط تؤثر في الإشارة المتاحة |
| Domain Shift | نموذج دُرّب على صور الإنترنت قد يتصرف بصورة مختلفة على Webcam أو هاتف أو في سيارة أو مدرسة أو مستشفى |
| اختلاف الأفراد والثقافات | التعبير ليس موحدًا بين جميع البشر |
| Label Uncertainty | قد تأتي تسمية صورة التدريب من Annotators أو تعبير مؤدى أو كلمة بحث أو Self-report أو السياق، ولكل طريقة حدودها |
| Class Imbalance | بعض التعبيرات تظهر في الـDataset أكثر بكثير من غيرها |
مخاطر التحيز
حين لا تمثل بيانات التدريب جميع الفئات تمثيلًا جيدًا، قد تختلف معدلات الخطأ باختلاف لون البشرة والعمر والجنس والثقافة وشكل الوجه والإعاقة وظروف التصوير.
ومن المهم ألا تُستخدم دراسة Gender Shades كأنها إثبات مباشر لتحيز Emotion Recognition؛ فهي درست تصنيف الجنس التجاري (Commercial Gender Classification) لا المشاعر. لكنها تظل مثالًا مهمًا على قدرة أنظمة تحليل الوجه على تقديم أداء غير متكافئ ديموغرافيًا، ولذلك يحتاج كل نظام واعٍ بالعاطفة إلى Bias Audit خاص بمهمته وبياناته.
مخاطر الخصوصية
يفتح استخدام الكاميرا لتخصيص المحتوى أسئلة لا يطرحها نظام التوصية التقليدي: هل يحتاج النظام إلى إرسال الفيديو إلى السحابة؟ هل تُخزَّن الصور؟ هل يُحتفظ بـFace Embeddings؟ هل تُربط بحساب المستخدم؟ هل تُستخدم لتدريب نموذج آخر؟ هل يستطيع المستخدم حذف بياناته؟ هل تعمل الميزة افتراضيًا أم باختيار المستخدم (Opt-in)؟ وهل يمكن استخدام النتيجة للإعلانات؟
قد يكون التصميم الأفضل من منظور الخصوصية أن تلتقط الكاميرا الإطار، فيُعالج على الجهاز نفسه، وينتج احتمالات التعبير، ثم يُحذف الإطار الخام فورًا، بحيث لا يغادر الفيديو الجهاز أصلًا إذا سمحت البنية والهدف بذلك. لكن المعالجة الطرفية لا تحل كل المشكلات الأخلاقية؛ فما يزال علينا تبرير سبب جمع الإشارة واستخدامها.
ماذا يقول قانون الذكاء الاصطناعي الأوروبي؟
هذا جانب محوري لأي مشروع يُنشر أو يُستخدم في الاتحاد الأوروبي. فـEU AI Act يعرّف نظام Emotion Recognition بأنه نظام AI يهدف إلى تحديد عواطف الأشخاص أو نواياهم أو استنتاجها اعتمادًا على بياناتهم البيومترية، ويحظر استخدام أنظمة AI لاستنتاج مشاعر الأشخاص في أماكن العمل والمؤسسات التعليمية، باستثناء استخدامات محددة لأسباب طبية أو تتعلق بالسلامة.
ولذلك فإن سيناريو «كاميرا الصف تقرأ إحباط الطالب وتغير المحتوى» قد لا يكون مجرد ميزة تقنية تحتاج موافقة، بل قد يقع ضمن استخدام محظور في الاتحاد الأوروبي إذا كان يعتمد على بيانات بيومترية لاستنتاج المشاعر ولا ينطبق عليه الاستثناء. كما تنص المادة 50 على أنه، في الاستخدامات المسموح بها، يجب على من ينشرون أنظمة Emotion Recognition إبلاغ الأشخاص المعرضين للنظام بتشغيله، مع تطبيق قواعد حماية البيانات ذات الصلة. وهذا يجعل مراجعة الخصوصية والقانون جزءًا من المعمارية، لا خطوة تضاف بعد اكتمال المنتج.
سياقات الاستخدام: أين يصح وأين لا يصح؟
الصحة النفسية
من غير المناسب بناء منطق من نوع: الوجه يبدو حزينًا، إذًا المستخدم مكتئب، إذًا اعرض عليه علاجًا. فتعبير الوجه ليس تشخيصًا. وإذا دخل المشروع في مجالات الاضطرابات النفسية، أو خطر الانتحار، أو التشخيص، أو العلاج، أو التوصيات الصحية، فنحن ننتقل إلى نطاق عالي المخاطر يحتاج تحققًا سريريًا، ومختصين، وحوكمة صارمة، وإشرافًا بشريًا، وتقييمًا قانونيًا وتنظيميًا. يمكن استخدام الإشارات العاطفية في البحث أو في دعم التجربة، لكن لا ينبغي تقديمها بديلًا مباشرًا عن المختص.
التعليم
توجد تقنيًا أبحاث تاريخية حول Affective Tutoring وأنظمة تستجيب للإحباط أو الحيرة، لكن التطبيق الواقعي اليوم يحتاج الفصل بين نوعين من التكيف. الأول Behavioral adaptation، المبني على إشارات مثل إعادة الطالب السؤال ثلاث مرات، أو تكرار أخطائه، أو توقفه طويلًا، أو طلبه تلميحًا؛ وهذه إشارات يمكن استخدامها لتعديل المحتوى دون استنتاج العاطفة من الوجه. والثاني Biometric emotion inference، مثل تحليل وجه الطالب بالكاميرا لاستنتاج الملل أو الإحباط، وهو استخدام محظور في المؤسسات التعليمية داخل الاتحاد الأوروبي، باستثناء حالات طبية أو حالات سلامة محددة. ويكشف هذا مبدأً مهمًا:
أحيانًا يمكن الحصول على التكيف الذي نريده من بيانات أقل حساسية.
الترفيه
يُعد الترفيه من أكثر السيناريوهات منطقية للتجربة، بشرط وجود موافقة واضحة، وعدم تخزين الفيديو دون حاجة، وإمكانية تعطيل الخاصية، وعدم الادعاء بمعرفة المشاعر الحقيقية، وعدم استغلال حالات الضعف. فيمكن مثلًا أن يختار المستخدم بنفسه تشغيل «وضع التوصيات حسب التعبير»، فيلتقط النظام لقطة اختيارية، ويعالجها محليًا، ويقدم اقتراحات قابلة للتعديل. وحتى هنا يجب تقييم ما إذا كانت الكاميرا تضيف قيمة تفوق مُحدِّد مزاج بسيطًا.
دور الأنظمة متعددة الأنماط
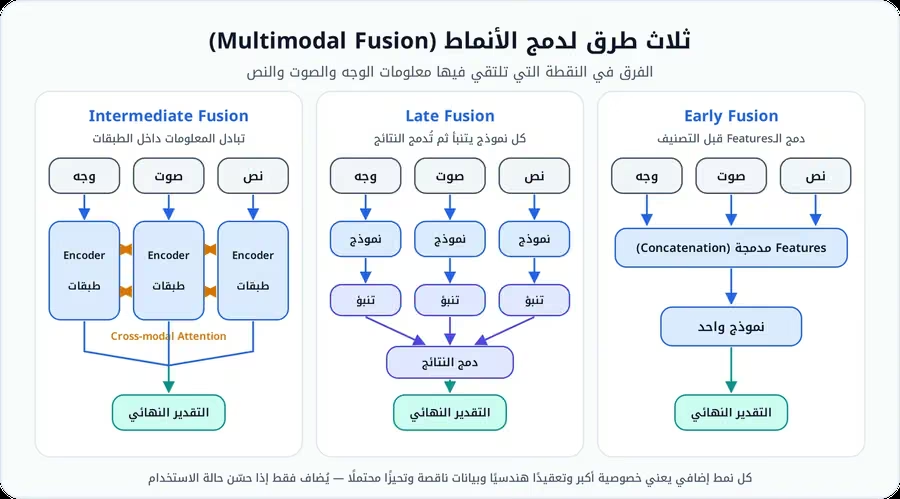
يمكن أن تُضاف إلى الوجه قنوات أخرى، مثل الصوت والنص والسلوك ومعدل ضربات القلب وتغيره (HR/HRV) والنشاط الكهربائي للجلد (EDA) وبيانات الأجهزة القابلة للارتداء. والفكرة أن الوجه وحده محدود، وأن المصادر الإضافية قد تحسن التمثيل في بعض المهام. وتعتمد الأنظمة في دمج هذه القنوات على ثلاث مقاربات:
| أسلوب الدمج | آليته |
|---|---|
| Early Fusion | دمج الميزات قبل التصنيف |
| Late Fusion | كل نموذج ينتج تنبؤه، ثم تُدمج النتائج |
| Intermediate / Cross-modal Fusion | نماذج Attention وTransformers تتبادل المعلومات بين الأنماط في طبقات داخلية |
لكن المزيد من البيانات ليس دائمًا أفضل؛ فكل قناة جديدة تعني عبئًا أكبر على الخصوصية، وتعقيدًا هندسيًا أعلى، وبيانات مفقودة، وتحديات في التزامن، وتحيزًا جديدًا، وتكلفة معالجة إضافية. ولهذا يجب إضافة نمط جديد حين يثبت أنه يحسّن حالة الاستخدام، لا لمجرد أن Multimodal AI تبدو أكثر تقدمًا.
كيف نصمم نظامًا عمليًا وأكثر أمانًا؟
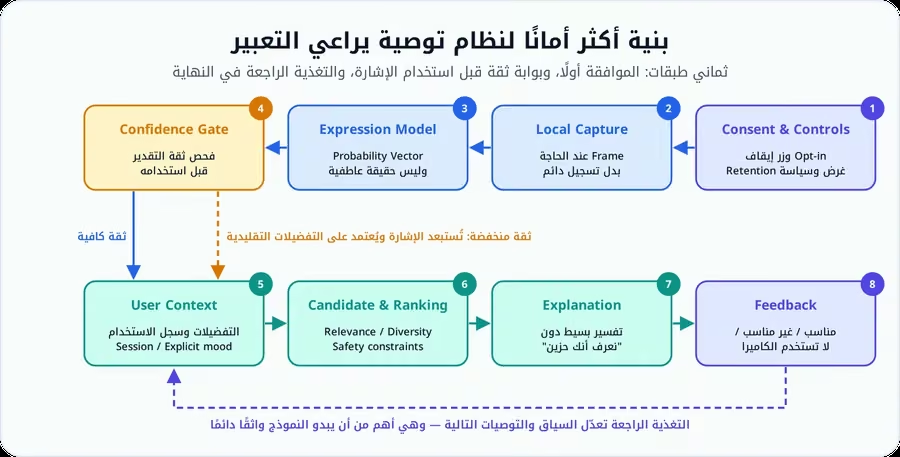
تجمع البنية التالية الدروس السابقة في ثماني طبقات متتابعة:
| الطبقة | دورها |
|---|---|
| Consent & Controls | قبل تشغيل الكاميرا: شرح واضح، وOpt-in، وزر إيقاف، وتحديد الغرض، وسياسة احتفاظ بالبيانات |
| Local Capture | التقاط إطار عند الحاجة بدل التسجيل الدائم إن لم تكن هناك ضرورة لفيديو مستمر |
| Expression Model | إنتاج Probability Vector، لا "حقيقة عاطفية" |
| Confidence Gate | إذا كانت الثقة منخفضة: تجاهل الإشارة، أو اطلب تغذية راجعة، أو عد إلى التفضيلات التقليدية |
| User Context | دمج التفضيلات والتاريخ والجلسة والمزاج الصريح والتعبير المقدَّر |
| Candidate Generation & Ranking | ترتيب المحتوى وفق الصلة والتنوع وتفضيل المستخدم والسياق الحالي وقيود السلامة |
| Explanation | تفسير بسيط مثل «اقترحنا هذه القائمة بناءً على تفضيلاتك ووضع التوصيات الحالي»، لا «نعرف أنك حزين» |
| Feedback | السماح للمستخدم بأن يقول: هذا مناسب، أو غير مناسب، أو لا تستخدم الكاميرا، أو غيّر مزاجي الحالي |
وهذه التغذية الراجعة في الطبقة الأخيرة أهم من محاولة جعل النموذج يبدو واثقًا دائمًا.
المقاييس التي يجب تقييمها
لا تكفي دقة تصنيف الوجه وحدها، بل يجب تقييم النظام على مستويين:
| المستوى | المقاييس |
|---|---|
| نموذج التعبير | Macro F1، وRecall لكل فئة، والمعايرة (Calibration)، ومصفوفة الالتباس، والأداء عبر الفئات الديموغرافية، والأداء عبر الأجهزة والإضاءة، والأداء عبر مجموعات بيانات مختلفة |
| نظام التوصية | Precision@K، وRecall@K، وNDCG، ومعدل النقر CTR عند ملاءمته، ومعدل التخطي، والرضا، والتنوع، والجِدّة، والاحتفاظ طويل المدى بحذر، ونسبة تعطيل المستخدم لميزة Emotion Input |
والأهم من ذلك كله سؤال واحد:
هل النظام الذي يستخدم الكاميرا أفضل فعلًا من Baseline لا يستخدمها؟
فإذا لم يحقق تحسنًا واضحًا، فقد لا تكون إضافة الكاميرا مبررة.
السؤال الذي يجب أن يسبق البناء
ليس السؤال «كيف نقرأ مشاعر المستخدم بالكاميرا؟»، بل:
ما القرار الذي نريد تحسينه، وما أقل البيانات حساسية التي تكفي لتحسينه؟
وقد تكون الإجابة سجل النقرات، أو اختيارًا يدويًا للمزاج، أو الوقت، أو نوع المحتوى، أو تغذية راجعة بسيطة. وإذا أثبت البحث أن تحليل التعبير يضيف قيمة مستقلة، يمكن إدخاله بعد ذلك بصورة اختيارية ومقيدة.
الخلاصة
تستطيع الرؤية الحاسوبية تحليل أنماط حركة الوجه وتحويلها إلى تقديرات رقمية تُستخدم إشارة داخل أنظمة التوصية. لكن التعبير الظاهر ليس مرادفًا للحالة العاطفية الداخلية، ولذلك لا ينبغي أن تكون تسمية مثل "Happy" أو "Sad" المصدر الوحيد لقرار التخصيص.
فالنظام الأكثر نضجًا هو الذي يحتفظ بعدم اليقين، ويدمج التعبير مع السياق والتفضيلات الأخرى، ويمنح المستخدم التحكم، ويختبر ما إذا كانت الإشارة تحسّن التوصيات فعلًا، ويعالج البيانات محليًا حين يناسب ذلك، ويراجع التحيز، ولا يستخدم الحالة العاطفية لاستغلال نقاط ضعف المستخدم، ويحترم القيود القانونية، خصوصًا في التعليم والعمل والصحة.
بهذا تتحول الفكرة من "كاميرا تعرف كيف أشعر" إلى "نظام يرى إشارات محدودة، يعرف حدودها، ويستخدمها بحذر لتحسين تجربة اختيار المحتوى." وهذا هو الفرق الجوهري بين عرض تقني مثير للاهتمام ومنتج مسؤول قابل للاستخدام.
المصادر والمراجع
Rosalind W. Picard — Affective Computing, MIT Media Laboratory Technical Report
https://vismod.media.mit.edu/tech-reports/TR-321.pdfBarrett et al. (2019) — Emotional Expressions Reconsidered
https://journals.sagepub.com/doi/full/10.1177/1529100619832930Goel et al. (2024) — Face and context integration in emotion inference, Nature Communications
https://www.nature.com/articles/s41467-024-46670-5Goodfellow et al. (2013) — Challenges in Representation Learning / FER2013
https://arxiv.org/abs/1307.0414Lucey et al. (2010) — The Extended Cohn-Kanade Dataset (CK+)
https://www.pitt.edu/~jeffcohn/biblio/2010%20Lucey%20CK+.pdfMollahosseini, Hasani & Mahoor (2017) — AffectNet
https://arxiv.org/abs/1708.03985Li, Deng & Du (2017) — RAF-DB / Expression Recognition in the Wild
https://openaccess.thecvf.com/content_cvpr_2017/html/Li_Reliable_Crowdsourcing_and_CVPR_2017_paper.htmlPolignano et al. (2021) — Towards Emotion-aware Recommender Systems
https://doi.org/10.1016/j.eswa.2020.114382Zhang et al. (2024) — Deep learning-based multimodal emotion recognition: systematic review
https://doi.org/10.1016/j.eswa.2023.121692EU Artificial Intelligence Act — Regulation (EU) 2024/1689, consolidated 27 July 2026
https://eur-lex.europa.eu/eli/reg/2024/1689/2026-07-27/eng
الأسئلة الشائعة حول المقال
هل يمكن معرفة مشاعر المستخدم من الكاميرا فقط؟
يمكن للنموذج تحليل تعابير وحركات الوجه وتصنيفها أو تقديرها، لكن لا ينبغي اعتبارها قراءة يقينية للحالة العاطفية الداخلية؛ السياق والثقافة والفروق الفردية تؤثر في المعنى.
ما الفرق بين Facial Recognition وFacial Expression Recognition؟
Facial Recognition تحاول تحديد هوية الشخص، بينما Facial Expression Recognition تحلل أنماط الحركة والتعبير في الوجه. النظام الثاني لا يحتاج بالضرورة إلى معرفة هوية المستخدم.
هل يجب إرسال الفيديو إلى الخادم؟
ليس بالضرورة. يمكن في بعض التطبيقات إجراء الاستدلال على الجهاز وإرسال نتائج محدودة بدل الفيديو الخام، ما يقلل بعض مخاطر الخصوصية.
هل يمكن ربط "الحزن" تلقائيًا بمحتوى سعيد؟
يمكن برمجيًا، لكنه ليس تصميمًا مثاليًا. المستخدمون يختلفون في رغبتهم بمحتوى يطابق حالتهم أو يغيرها، لذلك يفضل إدخال تفضيلات صريحة وتغذية راجعة.
ما أفضل Dataset لتحليل تعابير الوجه؟
لا توجد Dataset واحدة "أفضل" لكل المشاريع. FER2013 شائعة، وCK+ مخبرية، وAffectNet وRAF-DB أقرب إلى الصور الواقعية. الاختيار يعتمد على البيئة التي سيعمل فيها النظام.
هل استخدام الكاميرا في نظام توصية قانوني؟
يعتمد على البلد والغرض وطريقة معالجة البيانات. في الاتحاد الأوروبي، توجد قيود قوية، ومن بينها حظر استنتاج المشاعر من البيانات البيومترية في أماكن العمل والمؤسسات التعليمية، مع استثناءات ضيقة لأسباب طبية أو سلامة.
هل إضافة Emotion Recognition ترفع دقة التوصيات دائمًا؟
لا. توجد دراسات أظهرت فوائد في نطاقات محددة، لكن يجب مقارنتها مع Baseline فعلي. إذا لم تحسن النتائج بما يبرر المخاطر والتكلفة فلا توجد ضرورة لاستخدامها.
ما البديل الأبسط للكاميرا؟
يمكن استخدام Mood Selector اختياري، أو بيانات Session، أو Explicit Feedback، أو السلوك داخل التطبيق. أحيانًا تكون هذه الإشارات أقل حساسية وأكثر وضوحًا للمستخدم.
ماذا يعني أن نظام التوصية واعٍ بالعاطفة؟
هو نظام يحلل تعبيرات الوجه عبر الكاميرا ويحولها إلى تقديرات احتمالية، مثل درجة لكل فئة تعبيرية، ثم يستخدمها كإشارة سياقية إضافية لتخصيص المحتوى. ولا يعني ذلك أنه يعرف المشاعر الداخلية الحقيقية، بل يدمج هذا التقدير مع سجل الاستخدام والتفضيلات والسياق الحالي، فتكون الإشارة العاطفية Feature واحدة داخل النموذج لا مصدر القرار الوحيد.
كيف تتحول صورة الوجه إلى ترتيب للمحتوى المقترح؟
تمر العملية بمراحل: التقاط الصورة، ثم اكتشاف الوجه بنماذج مثل RetinaFace أو MTCNN، ثم المحاذاة عبر Facial Landmarks، ثم نموذج مثل CNN ينتج توزيعًا احتماليًا للتعبيرات. بعدها تضيف طبقة السياق تاريخ المستخدم وتفضيلاته، فتُولَّد عناصر مرشحة وتُرتب بدرجة متعددة العوامل، ثم يتعلم النظام من التغذية الراجعة مثل النقر والتخطي ومدة المشاهدة.
النقاش الهندسي والملاحظات (0)
سجّل الدخول للمشاركة في النقاش والرد على التعليقات والإعجاب بها.


