



التعرف على تعابير الوجه (Facial Expression Recognition — FER) مهمة في الرؤية الحاسوبية تهدف إلى تحليل الحركات والأنماط الظاهرة على الوجه، وتحويلها إلى تمثيل رقمي يستطيع النظام تصنيفه أو تقديره.
لكن ثمة تمييزًا أساسيًا يجب أن يسبق أي شرح:
التعرّف على تعبير الوجه لا يساوي قراءة المشاعر الداخلية مباشرة.
فالنظام قد يرى ارتفاع زوايا الفم، أو تقلص العضلات حول العين، أو اتساع العينين، أو انخفاض الحاجبين، أو انفتاح الفم، ثم يربط هذه الحركات بفئة أو احتمال أو بُعد عاطفي. لكنه لا يملك وصولًا مباشرًا إلى نية الشخص، ولا إلى تجربته الداخلية، ولا إلى السياق الاجتماعي الكامل، ولا إلى ثقافته، ولا إلى سبب التعبير.
ولهذا فالأدق هندسيًا أن نصف النظام سلسلةً متدرجة: تلتقط الكاميرا حركة وجهية مرئية، وتحلل برمجيات الرؤية الحاسوبية هذه الحركة فتستخرج منها representation للتعبير، ثم يصدر النظام في النهاية تقديرًا احتماليًا لفئة أو بُعد وجداني. وفي كل حلقة من هذه السلسلة يتراكم استدلال تقريبي، ولا توجد في أي نقطة منها قياسات مباشرة لـ"العاطفة الحقيقية"؛ فهذه ليست خرجًا تقنيًا يستطيع النظام إنتاجه، بل بناء تفسيري يقع خارج حدود ما تقيسه الكاميرا أصلًا.
ثلاث مهام تبدأ من صورة الوجه نفسها
تنطلق المهام الثلاث التالية من صورة وجه، لكنها مختلفة جذريًا في سؤالها وناتجها.
اكتشاف الوجه (Face Detection)
سؤالها «أين يوجد الوجه في الصورة؟»، وناتجها عادة صندوق إحاطة (Bounding Box)، وربما نقاط أولية للوجه. فعمليًا تدخل الصورة إلى النموذج فتخرج منه إحداثيات تقول إن وجهًا قد وُجد بين النقطتين (x1, y1) و(x2, y2). وهذا الناتج وحده لا يقول شيئًا عن هوية صاحب الوجه أو حالته؛ مهمته الوحيدة الإجابة عن "أين" بدقة تكفي لتفعيل المراحل التالية.
التعرف على الوجه (Face Recognition)
سؤالها «من هو هذا الشخص؟»، وتتخذ صورتين: التحقق (Verification)، أي هل هذا الشخص هو صاحب الهوية المدّعاة؟ والتعريف (Identification)، أي أي شخص في قاعدة البيانات يطابق هذا الوجه؟ وهي بذلك مهمة هوية بيومترية.
ومن أمثلتها مشروعنا نظام التحكم في الدخول بالتعرف على الوجه، الذي يطابق الوجه أمام الكاميرا مع الصور المرجعية للأشخاص المصرّح لهم ليميّزهم من الوجوه المجهولة — وهي مهمة مختلفة تمامًا عن قراءة تعبير الوجه. وأثناء بناء النظام لاحظنا أن جودة التقاط الوجه ترتبط بوضوح الصورة والإضاءة وزاوية الكاميرا، فراعينا موضع الكاميرا ومجال رؤيتها في تصميم النموذج الأولي؛ وهي العوامل نفسها التي تضاعف صعوبة قراءة التعبيرات.
التعرف على تعابير الوجه (FER)
سؤالها «ما النمط التعبيري الظاهر على الوجه؟»، وقد يكون ناتجها توزيعًا من قبيل: neutral بدرجة 0.44، وhappy بدرجة 0.31، وsurprise بدرجة 0.12، وsad بدرجة 0.07، وother بدرجة 0.06.
| المهمة | السؤال |
|---|---|
| Face Detection | أين الوجه؟ |
| Face Recognition | من الشخص؟ |
| FER | ما التعبير أو النمط الوجهي الظاهر؟ |
والخلط بين هذه المهام يقود إلى تصميمات خاطئة وتقييمات غير صحيحة.
هل FER هي نفسها Emotion Recognition؟
ليس تمامًا. فـFacial Expression Recognition تتعامل مع الإشارة المرئية الصادرة عن الوجه، أما Emotion Recognition فمفهوم أوسع قد يحاول تقدير الحالة العاطفية اعتمادًا على الوجه والصوت والنص ووضعية الجسم، وعلى إشارات فسيولوجية مثل ECG وHRV وEDA/GSR، إضافة إلى السياق. فالوجه قناة واحدة فقط بين قنوات.
ويكتسب هذا الفرق أهميته من أن الأبحاث النفسية الحديثة تحذر من افتراض علاقة ثابتة واحدة بين حركة وجه محددة وشعور داخلي محدد. فقد خلصت مراجعة علمية واسعة نُشرت عام 2019 إلى ثلاث مشكلات رئيسية في الاستدلال على المشاعر من حركات الوجه وحدها: محدودية الثبات، وغياب تطابق واحد-لواحد بين الحركة وفئة الشعور، وأثر السياق والثقافة في التعبير والتفسير. ولذلك فنظام FER مسؤول هندسيًا عن تحليل تعبير ظاهر، لا عن الادعاء بأنه "يعرف ما يشعر به الإنسان".
FACS: لغة لوصف حركة الوجه
Facial Action Coding System — FACS نظام لوصف حركات الوجه بطريقة قابلة للترميز. وفكرته الأساسية أننا بدل أن نكتب «هذا الشخص غاضب»، نصف ما يحدث على الوجه فعلًا: انخفاض الحاجب، أو ارتفاع الخد، أو شد الجفن، أو ارتفاع زاوية الفم، أو انفتاح الفك. وتسمى هذه العناصر Action Units — AUs.
أمثلة على وحدات الحركة
| الوحدة | الحركة |
|---|---|
| AU1 | Inner Brow Raiser |
| AU2 | Outer Brow Raiser |
| AU4 | Brow Lowerer |
| AU6 | Cheek Raiser |
| AU12 | Lip Corner Puller |
| AU25 | Lips Part |
| AU26 | Jaw Drop |
وميزة FACS أنه يصف الحركة المرئية، وهذا أدق علميًا من مساواة كل Action Unit بشعور داخلي ثابت.
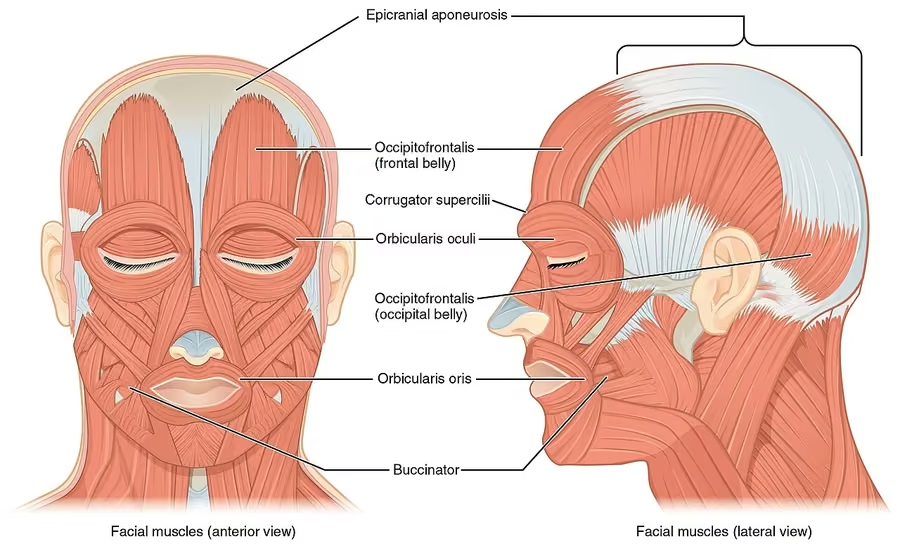
هل تعني AU12 "السعادة"؟
ليس بهذه البساطة. فـAU12 تصف حركة رفع زوايا الفم، وقد تظهر في ابتسامة اجتماعية، أو فرح، أو مجاملة، أو سخرية، أو موقف مصطنع أمام الكاميرا. ولذلك:
Action Unit = حركة وجهية قابلة للرصد، وليست إثباتًا مباشرًا لشعور داخلي.
ثلاث طرق لتمثيل تعابير الوجه
يمكن تصميم نظام FER بأكثر من نوع من المخرجات، ولكل منها منطقه.
التصنيف الفئوي للتعبير
الفئات الشائعة في كثير من مجموعات البيانات هي Happiness وSadness وAnger وFear وDisgust وSurprise وNeutral، وتُضاف إليها أحيانًا Contempt. ويكون الناتج احتمالًا لكل فئة: P(happy) وP(sad) وP(anger) وهكذا.
اكتشاف وحدات الحركة
بدل اختيار فئة عاطفية، يتنبأ النظام بوجود وحدات الحركة أو غيابها، كأن تكون AU4 نشطة وAU6 غير نشطة وAU12 نشطة. وغالبًا ما تكون المهمة متعددة التسميات (Multi-label)، لأن عدة وحدات قد تظهر في الوقت نفسه.
التكافؤ والاستثارة (Valence / Arousal)
بدل الفئات المنفصلة، يمكن تمثيل الحالة في فضاء مستمر: فـValence يمتد تقريبًا من السلبي إلى الإيجابي، وArousal يمتد من منخفض التنشيط إلى مرتفعه. وهذا يناسب الحالات التي لا نريد فيها إجبار كل تعبير على فئة صلبة واحدة.
من الكاميرا إلى النتيجة: خط معالجة FER
يبدأ خط المعالجة بإطار قادم من الكاميرا، فتمر عليه مرحلة اكتشاف الوجه لتحديد مواقع الوجوه في المشهد، ثم تتبع الوجه الذي يحفظ هوية كل وجه عبر الإطارات المتتالية ويمنع تقطع القياسات بين إطار وآخر. يلي ذلك استخراج النقاط المرجعية على ملامح الوجه، وتُبنى عليها المحاذاة التي توحّد وضعية الرأس وزاويته، ثم القص والتطبيع لإنتاج صورة وجه معيارية جاهزة للتحليل.
تدخل هذه الصورة بعد ذلك إلى مرحلة استخراج السمات عبر نموذج تعلم عميق ينتج representation داخلية، يصدر النظام على أساسها تنبؤًا للتعبير أو لوحدات AU مصحوبًا بدرجة ثقة أو عدم يقين تعكس مدى موثوقية القرار. وهذه الدرجات ليست ترفًا؛ فالتطبيق النهائي يحتاجها ليقرر متى يثق بالنتيجة ومتى يتراجع إلى سلوك احتياطي، لأن كل مرحلة في السلسلة، من الاكتشاف إلى التنبؤ، قد تكون مصدر خطأ مستقلًا يتراكم في النتيجة النهائية.
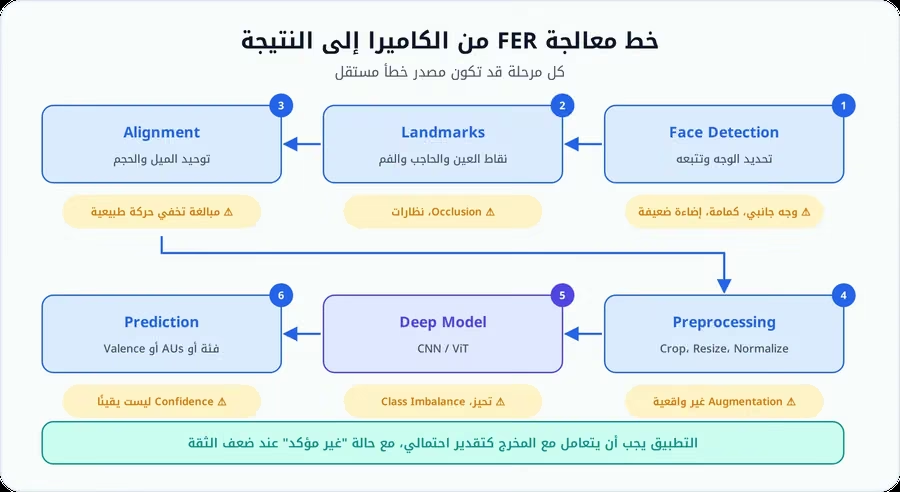
اكتشاف الوجه
أول خطوة تحديد الوجه. فإذا كانت الصورة تضم أكثر من شخص، أو خلفية مزدحمة، أو وجهًا جانبيًا، أو كمامة، أو إضاءة ضعيفة، فإن فشل كاشف الوجه يعني أن بقية خط المعالجة قد لا تبدأ أصلًا. وتستخدم الأنظمة الحديثة نماذج تعلم عميق لاكتشاف الوجوه، بدل الاكتفاء بالطرق الكلاسيكية مثل Viola-Jones.
النقاط المرجعية للوجه (Facial Landmarks)
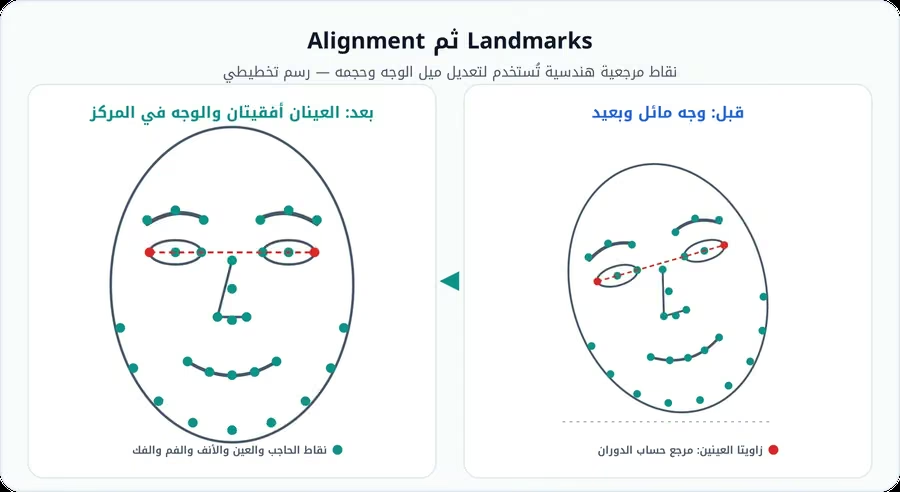
بعد اكتشاف الوجه يمكن تقدير نقاط مرجعية مثل زوايا العينين والحاجبين والأنف وزوايا الفم والفك، فتُسجَّل مثلًا إحداثيات زاوية العين اليسرى وزاوية العين اليمنى وطرفي الفم. وتُستخدم هذه النقاط في المحاذاة، وحساب المسافات، وتقدير وضعية الرأس (Head pose)، واستخراج ميزات هندسية، وتتبع الحركة عبر الفيديو. لكن إحداثيات النقاط المرجعية وحدها لا تمثل "المشاعر"؛ إنها قياسات هندسية فحسب.
محاذاة الوجه
إذا كان الوجه مائلًا أو بعيدًا أو مستدارًا، تصبح مقارنة الميزات أصعب. فتحاول المحاذاة توحيد وضع الوجه باستخدام النقاط المرجعية: جعل خط العينين أفقيًا، وتوسيط الوجه، وتوحيد حجمه. وهذا يقلل التباين غير المرتبط بالتعبير نفسه. لكن المحاذاة المبالغ فيها قد تخفي بعض الحركة الطبيعية، ولذلك يجب اختبار خط المعالجة على بيانات حقيقية.
المعالجة المسبقة
قد تشمل المعالجة المسبقة القص وتغيير الحجم وتطبيع الألوان وضبط التباين وتطبيع البيانات. وفي التدريب يمكن استخدام تعزيز البيانات، كالقلب الأفقي، والتدوير الطفيف، والقص، وتغيير السطوع، ومحاكاة الحجب. لكن يجب أن تكون هذه التحويلات منطقية؛ فإذا جعل التعزيز الوجه غير واقعي، فقد يتعلم النموذج بيانات لا تمثل بيئة التشغيل.
من السمات اليدوية إلى التعلم العميق
كيف كانت FER تعمل قبل التعلم العميق؟
اعتمدت المنهجيات التقليدية على استخراج الميزات يدويًا، في صنفين رئيسيين: الميزات الهندسية، مثل المسافة بين الحاجبين، وعرض الفم، وارتفاع انفتاحه، وزاوية الحاجب، ونسبة اتساع العين؛ وميزات المظهر، مثل LBP ومرشحات Gabor وHOG.
تتجمع هذه السمات في متجه يغذي مصنفًا تقليديًا، كـSVM أو KNN أو Random Forest، يتعلم رسم الحدود الفاصلة بين فئات التعابير في فضاء السمات، فتخرج الفئة الأقرب للمثال الجديد. وقد يكون هذا النهج خفيفًا، وقابلًا للتحليل نسبيًا، ومناسبًا للبيئات المقيدة، لكنه يدفع ثمن اعتماده على هندسة السمات اليدوية: حساسية أعلى للتغيرات غير المتوقعة، وصعوبة في تمثيل الأنماط المعقدة التي لم يتوقعها مصمم السمات.
كيف غيّرت CNN التعرف على تعابير الوجه؟
تتعلم CNN الميزات البصرية مباشرة من الصور. ويمر النهج العميق المبسط بأربع مراحل: يدخل وجه محاذى إلى backbone التفافي يستخرج طبقة بعد طبقة سمات تتدرج من الخام إلى المجرد، فتتجمع في representation بصرية غنية تُغذّى إلى رأس تصنيف يحوّلها إلى احتمالات للتعابير. والفارق الجوهري أن الشبكة تتعلم هذه التمثيلات من البيانات نفسها، بدل أن يحدد المهندس يدويًا قاعدة مثل «قِس المسافة بين زاويتي الفم»، فتلتقط أنماطًا أعقد وأدق مما يمكن صياغته بقواعد يدوية.
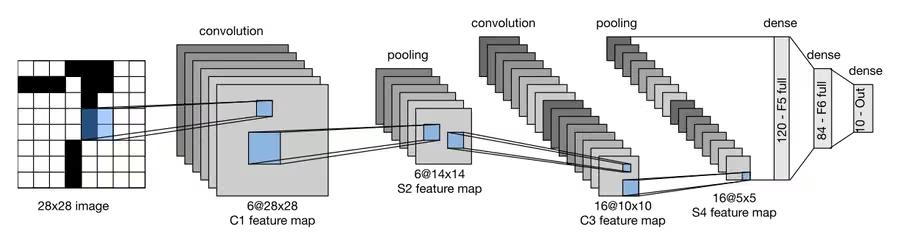
لكن هذا لا يعني أنها تتعلم "المشاعر نفسها"، بل أنماطًا مرتبطة بالتسميات الموجودة في الـDataset. فإذا كانت التسميات مشوشة أو منحازة أو مؤداة أو ضيقة ثقافيًا، فسيتعلم النموذج هذه القيود أيضًا.
ما بعد CNN
ليست CNN البنية الحديثة الوحيدة؛ فـFER الحديثة قد تستخدم backbones التفافية، وResNet، ومعماريات شبيهة بـEfficientNet، وآليات الانتباه، وVision Transformers، ونماذج زمنية للفيديو، ونماذج هجينة بين CNN وTransformer. وتركز الأبحاث الحديثة خصوصًا على المتانة أمام وضعية الرأس، والحجب، وعدم توازن الفئات، والنشر الخفيف، والديناميكيات الزمنية. لكن المعمارية ليست المشكلة الوحيدة، وغالبًا ما تكون جودة البيانات وتعريف التسمية أهم من تغيير الـBackbone.
البعد الزمني: هل تكفي الصورة الثابتة؟
التعبير حركة في الزمن
تكفي الصورة الثابتة أحيانًا، لكن الفيديو يوفر معلومات إضافية، لأن تعبير الوجه حركة زمنية. فالتعبير الواحد يتطور عبر أطوار يمكن تمييزها: يبدأ الوجه من حالة محايدة، ثم يأتي طور البداية (Onset) حيث تنقبض العضلات تدريجيًا، وصولًا إلى الذروة (Apex) عند اكتمال التعبير، وأخيرًا طور التلاشي (Offset) حين يعود الوجه إلى وضعه السابق.
ترى الصورة الثابتة إطارًا واحدًا من هذه المسيرة، وقد تقع على لحظة غامضة لا تكشف أيًا منها. أما الفيديو فيلتقط سرعة الحركة واتجاهها وتطورها ومدتها وديناميكياتها الدقيقة (Micro-dynamics)، وهي إشارات زمنية قد تساعد على التمييز بين تعبير عفوي عابر وتعبير مصطنع ممتد. ولهذا تُستخدم مع الفيديو أدوات مثل 3D CNN، وRNN/LSTM تاريخيًا، والالتفاف الزمني (Temporal convolution)، وVideo Transformers، والتدفق البصري (Optical flow)، ومسارات النقاط المرجعية.
صورة ثابتة أم فيديو؟
| العنصر | صورة ثابتة | فيديو |
|---|---|---|
| البيانات | Frame واحدة | Sequence |
| التكلفة | أقل | أعلى |
| temporal dynamics | لا | نعم |
| tracking | غير مطلوب غالبًا | مهم |
| latency | أبسط | أعقد |
| micro-movements | محدودة | أفضل نسبيًا |
| privacy | أقل حجمًا | أعلى حساسية |
فإذا كان التطبيق يحتاج التعبير اللحظي فقط فقد تكفي الصورة، وإذا كان يحتاج تغير التعبير بمرور الوقت فالفيديو أفضل تقنيًا، لكنه أعلى كلفة ومخاطر.
أهم قواعد بيانات FER
FER2013
ظهرت ضمن تحديات ICML 2013، وتضم 35,887 صورة رمادية بحجم 48×48 موزعة على سبع فئات تعبيرية. وتقسيمها الشائع 28,709 صورة للتدريب، و3,589 للتحقق أو الاختبار العام، و3,589 للاختبار الخاص. وميزتها أنها سهلة للاختبار والتعليم وواسعة الاستخدام، لكن قيودها واضحة: دقة صور منخفضة، وتسميات فيها ضوضاء، وصور ويب غير مضبوطة، وتمثيل ناقص لسيناريوهات العالم الحقيقي.
CK+
Extended Cohn-Kanade — CK+ مجموعة بيانات مخبرية كلاسيكية، تضم 593 سلسلة من 123 مشاركًا، تنتقل من الحياد إلى ذروة التعبير، ومنها 327 سلسلة تحمل تسمية عاطفية من الفئات المحددة. وهي مهمة لفهم التعبير الوجهي الديناميكي، لكنها ليست مرآة مثالية للعالم الحقيقي، لأن كثيرًا من تعبيراتها مصطنع أو موجَّه، أمام كاميرا مضبوطة، وبإضاءة ووضعية أسهل من البيئة الحقيقية. وهذه نقطة جوهرية عند مقارنة أرقام الدقة.
AffectNet
صُممت AffectNet لتمثيل التعبيرات "in the wild"، فجمعت نسختها الأصلية أكثر من مليون صورة وجه من الإنترنت باستخدام كلمات بحث مرتبطة بالعاطفة بعدة لغات، ووُسم جزء كبير منها يدويًا. وتدعم نوعين من التسميات: التعبيرات الفئوية، والتكافؤ والاستثارة، وهي ميزة مهمة لأنها لا تحصر كل تعبير في فئة منفصلة. لكن صور الإنترنت نفسها تحمل تحيز الاختيار، والتحيز الثقافي، وعدم اليقين في التسميات، وعدم توازن الفئات.
RAF-DB
تضم Real-world Affective Faces Database 29,672 صورة وجه واقعية بتسميات أساسية ومركبة، قُيّمت كل صورة منها عدة مرات عبر الحشد الجماعي (Crowdsourcing). وتكشف RAF-DB مشكلة مهمة:
تعبيرات العالم الحقيقي أكثر تنوعًا وتعقيدًا من التعبيرات المخبرية النموذجية.
فقد لاحظت الورقة الأصلية أن وحدات الحركة المرتبطة بالفئات في بيانات العالم الحقيقي أكثر تنوعًا منها في قواعد البيانات المخبرية.
مقارنة مبسطة
| Dataset | الحجم | البيئة | القوة | القيد |
|---|---|---|---|---|
| FER2013 | 35,887 صورة | Web / 48×48 | Benchmark شائع | دقة منخفضة وLabels noisy |
| CK+ | 593 sequence / 123 شخصًا | مختبر | Dynamic onset→apex | Posed ومضبوطة |
| AffectNet | >1M collected | In-the-wild | حجم كبير + Valence/Arousal | imbalance/label uncertainty |
| RAF-DB | 29,672 صورة | In-the-wild | crowdsourced + compound expressions | لا تلغي تحيز التوزيع |
ولا تصح مقارنة الدقة بين مجموعة بيانات وأخرى دون فهم اختلاف الفئات، والتقسيم، وعدد الصور، وجودة التسميات، والبيئة، وبروتوكول التقييم.
من المختبر إلى الواقع
لماذا تتألق النماذج في المختبر ثم تفشل في الواقع؟
السبب Domain Shift. فقد يتدرب النموذج على وجوه أمامية، وإضاءة جيدة، وتعبيرات قوية، وخلفيات نظيفة، ثم يُستخدم على هاتف محمول، بزاوية 40 درجة، في إضاءة ليلية، مع نظارات أو لحية أو كمامة، وأمام تعبير خفيف. فالنموذج ببساطة لم يواجه التوزيع نفسه من قبل.
أهم تحديات FER في الواقع
| التحدي | ما يحدث |
|---|---|
| Head Pose | تختفي أجزاء من الوجه، وتتغير المسافات بفعل المنظور، وتتغير النقاط المرجعية |
| Occlusion | كمامة أو يد أو شعر أو نظارات شمسية أو ميكروفون أو نظارة VR تحجب أجزاء من الوجه |
| Lighting | يغير الضوء النسيج والظلال والتباين، وقد يجعل التجاعيد والحركات الدقيقة أوضح أو أخفى |
| Subtle Expressions | التعبير قد يكون خفيفًا أو سريعًا أو جزئيًا أو متناقضًا، لا "ابتسامة كبيرة" أو "غضبًا واضحًا" |
| Class Imbalance | Happiness أسهل وأوفر في بعض المجموعات، بينما تقل disgust وfear وcontempt |
وما تزال أبحاث 2024–2025 تعالج الحجب بوصفه أحد التحديات الأساسية، ما يؤكد أن المشكلة ليست "محلولة" بمجرد استخدام التعلم العميق. أما عدم توازن الفئات فقد يمنح النموذج دقة جيدة بينما يضعف جدًا على الفئات القليلة.
لماذا الدقة العامة غير كافية؟
افترض مجموعة بيانات تضم 7000 صورة Happy، و5000 صورة Neutral، و300 صورة Disgust، و200 صورة Fear. فالنموذج الذي ينجح في Happy وNeutral ويفشل في Fear قد يحتفظ بدقة إجمالية تبدو جيدة. ولهذا يجب فحص Recall لكل فئة، وMacro F1، والدقة المتوازنة (Balanced Accuracy)، ومصفوفة الالتباس، والأداء حسب المجموعات الفرعية.
ماذا تعني الثقة في FER؟
قد يُخرج النموذج درجة 0.88 لفئة happy، لكن هذه ليست بالضرورة «احتمالًا بنسبة 88% أن الشخص سعيد داخليًا»، بل درجة داخل نموذج وتوزيع تسميات محددين. والصياغة الأدق: «النموذج يمنح فئة happy أعلى درجة بناءً على النمط الوجهي وفق تدريبه».
وفي التطبيقات الحساسة يجب التفكير أيضًا في المعايرة، وعدم اليقين، والامتناع عن القرار (Abstention)؛ فإذا انخفضت الثقة عن عتبة محددة، يُعلن النظام أن النتيجة "غير مؤكدة" بدل إجباره على قرار.
حدود الاستدلال: من حركة الوجه إلى الشعور
هل يمكن استنتاج المشاعر الداخلية من الوجه بدقة؟
هذه أهم نقطة في المقال كله. فالحركة الوجهية تحمل معلومات، لكن العلاقة بين الحركة الوجهية (Facial Movement) والحالة العاطفية الداخلية (Internal Emotional State) ليست ربطًا ثابتًا وعالميًا وواحدًا لواحد. وتشير المراجعة العلمية الواسعة المنشورة في Psychological Science in the Public Interest عام 2019 إلى أنه لا يوجد ثبات (Reliability) كافٍ يجعل كل حالة شعورية تظهر بالحركة نفسها دائمًا، ولا خصوصية (Specificity) تجعل كل تشكيل وجهي يخص شعورًا واحدًا فقط، وأن السياق والثقافة يؤثران في التعبير والتفسير.
فالابتسامة مثلًا قد تعني فرحًا، أو توترًا، أو مجاملة، أو إحراجًا، أو سخرية، أو محاولة لإخفاء شعور آخر. ولذلك يجب استخدام لغة مثل "Facial expression estimate" و"expression-related signal" و"probabilistic affective inference"، وتجنب عبارات مثل "AI knows how you feel" و"camera reads emotions" و"detects the true emotion".
FACS أيضًا ليس كاشفًا للمشاعر
لا يقول FACS إن اجتماع AU6 مع AU12 يعني أن الشخص سعيد داخليًا، بل يصف نشاطًا وجهيًا فحسب.
يستطيع مهندس النظام أن يبني فوق هذه الوحدات ربطًا بفئات معينة، لكن ذلك يصبح Model assumption يحتاج إلى تحقق. وهذه نقطة أساسية للفصل بين القياس والتفسير.
دور السياق
انظر إلى تعبير وجه واحد دون سياق، فقد يبدو غامضًا. ثم أضف صوت الشخص، والجملة التي قالها، والحدث، والتفاعل، ووضعية الجسم، والثقافة، فقد يتغير تفسيرك كليًا. ولهذا تتجه الحوسبة العاطفية إلى Multimodal systems، مع أن النظام متعدد الوسائط نفسه لا يصل إلى "حقيقة داخلية" مباشرة، بل يملك إشارات أكثر فقط.
نموذج التعبير الوجهي مقابل النموذج الوجداني متعدد الوسائط
يأخذ نموذج تعبير الوجه صورة الوجه وحدها ويصدر عنها احتمالات للتعابير: قناة مدخلات واحدة وخرج واحد محدود. أما النموذج الوجداني متعدد الوسائط فيغطي أرضًا أوسع بكثير: تعبير الوجه من الكاميرا، ونبرة الصوت وميزاته، ومحتوى النص المنطوق، وإشارات فسيولوجية مثل نبض القلب والتوصيل الجلدي، إضافة إلى سياق الاستخدام الذي يفسّر الوجه نفسه بطرق مختلفة في مواقف مختلفة. وتُدمج هذه القنوات في مرحلة Fusion متعددة الوسائط، فينتج تقدير احتمالي للحالة الوجدانية أعمق مما تبلغه أي قناة منفردة.
يمنح هذا التعدد النظام متانة أكبر حين تضعف قناة فتعوضها أخرى، لكنه يضاعف أعباء الخصوصية، والتعقيد، ومزامنة البيانات بين القنوات، والتعامل مع القنوات المفقودة، وعبء الحصول على الموافقة.
هل "المشاعر الست الأساسية" حقيقة نهائية؟
هي إطار مؤثر جدًا في البحث والتعليم وقواعد البيانات، لكن التعامل معها كأنها ست حالات عالمية ثابتة لكل منها وجه محدد تبسيط مفرط. فالنماذج الفئوية مفيدة عمليًا، لكن توجد أيضًا مناهج بعدية (Valence/Arousal)، ومناهج وحدات الحركة، ومناهج التقييم المعرفي والسياق (Appraisal/contextual approaches)، والتعبيرات المركبة. فاختيار التسميات قرار نمذجة، لا اكتشاف مباشر لست حالات بيولوجية منفصلة.
التحيز الديموغرافي
إذا كانت مجموعة البيانات لا تمثل السكان الفعليين، فقد يتفاوت الأداء بين المجموعات. وتشمل مصادر التحيز توزيع الأعمار، ولون البشرة، والجنس، والثقافة، وجودة الكاميرا، وطريقة جمع التسميات، والفرق بين التعبيرات المؤداة والتلقائية. فلا يكفي اختبار الدقة العامة، بل يجب عند الحاجة قياس الأداء حسب المجموعات الفرعية (performance by subgroup)، مع التأكد من أن هذا التحليل نفسه قانوني وأخلاقي.
الخصوصية والقانون
بيانات شديدة الحساسية حتى دون هوية
قد يتعامل FER عبر الكاميرا مع معلومات شديدة الحساسية. فحتى إذا لم يحفظ النظام هوية المستخدم، فقد يعالج صورة الوجه الخام، والنقاط المرجعية، والـEmbeddings، واحتمالات التعبير، والطوابع الزمنية، وملفًا سلوكيًا، وهي بيانات قد تسمح ببناء ملف تعريفي عن المستخدم.
الخصوصية بالتصميم في نظام FER
المبدأ الأول المعالجة المحلية: حين تسمح قدرات الجهاز، يُفضَّل أن تعالج دائرة FER إطار الكاميرا على الجهاز نفسه وتُخرج متجه التعبير فقط، بدل رفع فيديو خام إلى السحابة. والفرق ليس تنفيذيًا فحسب، بل أخلاقي وهندسي أيضًا: ففي المسار المحلي لا تغادر صورة الوجه جهاز المستخدم أصلًا، وتنحصر البيانات القابلة للتسريب في متجه أرقام مجرد لا يمكن إعادة بناء الوجه منه.
والمبدأ الثاني عدم تخزين الفيديو دون حاجة: فإذا كانت المهمة تحتاج نتيجة لحظية فقط، يُعالج الإطار، وتُستخرج النتيجة، وتُحذف الصورة الخام. والثالث تقليل البيانات (Data Minimization): فلا يُجمع الصوت أو الموقع أو الهوية ما لم تكن ضرورية للمهمة. والرابع تقييد الغرض (Purpose Limitation): فإذا وافق المستخدم على تحسين واجهة التطبيق، فلا تتحول البيانات لاحقًا إلى بناء ملفات نفسية إعلانية دون أساس واضح وموافقة أو أساس قانوني مناسب. والخامس الشفافية بشأن ما يستنتجه النظام: فلا يجوز أن يظن المستخدم أن "الكاميرا تعمل فقط" بينما يحلل النظام تعبيرات وجهه.
ماذا يقول قانون الذكاء الاصطناعي الأوروبي؟
يضع تنظيم الاتحاد الأوروبي للذكاء الاصطناعي قيودًا مباشرة على بعض استخدامات Emotion Recognition:
المادة 5 تحظر استخدام أنظمة AI لاستنتاج مشاعر الأشخاص في أماكن العمل والمؤسسات التعليمية، باستثناء الاستخدامات الموضوعة لأسباب طبية أو سلامة.
وهذا بالغ الأهمية لأي نظام FER يُسوَّق على أنه يقيس مشاعر الموظفين، أو يراقب تركيز الطلاب، أو يستنتج الحالة النفسية للمتعلم؛ فلا يجوز في الاتحاد الأوروبي التعامل مع هذه التطبيقات كأنها حالات استخدام عادية. وقد تختلف القوانين في دول أخرى، ولذلك تلزم مراجعة قانونية بحسب السوق.
هل الوجه بيانات بيومترية دائمًا؟
قد تصبح الصورة الوجهية بيانات بيومترية حين تُعالج تقنيًا لأغراض تتيح التعرف الفريد على الشخص أو تؤكده، وفق السياق القانوني. أما FER فقد لا تحتاج الهوية أصلًا، لكن هذا لا يجعل بيانات الوجه "غير حساسة". فثمة فرق بين سؤال «من أنت؟» وسؤال «ما النمط الوجهي الذي تُظهره؟»، لكن كليهما يحتاج تصميمًا واضحًا للخصوصية.
هل FER مناسبة للصحة النفسية؟
يجب الحذر الشديد هنا؛ فتعبير الوجه وحده لا يكفي لتشخيص الاكتئاب أو القلق أو اضطراب ما بعد الصدمة أو خطر الانتحار أو أي اضطراب نفسي. وقد يكون إشارة داخل بحث أو نظام سريري أكبر إذا كان متحققًا منه، وخاضعًا للتنظيم حيث يلزم، وتحت إشراف مختصين مؤهلين. لكن لا ينبغي تحويل مصنّف وجه إلى "تشخيص نفسي".
كيف تبني نظام FER أكثر مسؤولية؟
الخطوة 1: عرّف المخرج الصحيح
بدل أن تكتب في متطلبات المشروع «Detect emotion»، اكتب «Estimate visible facial-expression category» أو «Detect selected Action Units». فهذه الصياغة تجبر الفريق على تحديد ما يقيسه فعلًا.
الخطوة 2: حدد حالة الاستخدام
هل الهدف تحريك شخصية رمزية (Avatar animation)، أم إتاحة الوصول (Accessibility)، أم بحث في التفاعل بين الإنسان والحاسوب، أم تكييف المحتوى، أم مراقبة السائق، أم بحث طبي؟ فالمخاطر تختلف جذريًا من حالة إلى أخرى.
الخطوة 3: اختر التسميات بحذر
قد يكون الأنسب وحدات الحركة، أو التكافؤ والاستثارة، أو فئات التعبير، بحسب المهمة.
الخطوة 4: اجمع Dataset ممثلة
اختبر تنوع الأعمار، وألوان البشرة، ووضعيات الرأس، والإضاءة، وأنواع الكاميرات، والحجب.
الخطوة 5: قسّم البيانات حسب الأشخاص
من الأخطاء الشائعة وجود صور الشخص نفسه في التدريب والاختبار معًا، فيتعلم النموذج ميزات مرتبطة بهوية الشخص بدل التعبير. ولذلك استخدم في التقييم الحقيقي تقسيمًا مستقلًا عن الأشخاص (subject-independent split).
الخطوة 6: اختبر عبر مجموعات بيانات مختلفة
درّب على مجموعة بيانات واختبر على أخرى، فهذا يكشف ضعف التعميم أفضل بكثير من الاختبار داخل المجموعة نفسها.
الخطوة 7: لا تكتفِ بالدقة
راقب Macro F1، وRecall لكل فئة، ومصفوفة الالتباس، ومقاييس المجموعات الفرعية، والمعايرة.
الخطوة 8: أضف حالة "غير مؤكد"
ليس مطلوبًا أن يصنف النظام كل إطار، بل يمكن أن تتضمن مخرجاته إلى جانب فئات مثل neutral وhappy-like حالتين صريحتين هما uncertain وface not reliable.
الخطوة 9: افصل الهوية عن التعبير
إذا لم تكن تحتاج إلى التعرف على الوجه، فلا تبنِه.
الخطوة 10: قلّل الاحتفاظ بالبيانات
خصوصًا الإطارات الخام، والفيديو، والـEmbeddings المرتبطة بالهوية.
النقاط المرجعية أم التمثيل العميق؟
| النهج | يناسب حين |
|---|---|
| Landmark-based | نريد الهندسة، وقابلية تفسير نسبية، وحوسبة منخفضة، وتحليل الحركة ووحدات AU |
| End-to-end Deep Model | تكون الصور معقدة، وتتوافر البيانات، ونحتاج تعلم النسيج والهندسة ضمنيًا |
| Hybrid | نجمع ميزات صورة RGB والنقاط المرجعية والتدفق البصري ووحدات الحركة، وقد يتفوق في بعض السيناريوهات |
ولا يوجد نهج واحد فائز في كل الحالات.
كيف تختبر FER في العالم الحقيقي؟
مصفوفة الاختبار
أنشئ مصفوفة اختبار تغطي العوامل التي تواجهها في التشغيل الفعلي:
| العامل | الحالات |
|---|---|
| الضوء | ساطع / منخفض / خلفي |
| Pose | أمامي / يمين / يسار / أعلى / أسفل |
| Occlusion | نظارات / كمامة / يد / شعر |
| الكاميرا | هاتف / Webcam / CCTV |
| المسافة | قريب / متوسط / بعيد |
| التعبير | قوي / خفيف / محايد |
| الحركة | ثابت / Moving |
| المستخدم | مجموعات متنوعة |
ثم قِس نجاح الاكتشاف، وأداء FER، وزمن الاستجابة، وحالات الفشل، وعدم اليقين.
ماذا تفعل عندما يفشل النظام؟
لا تخفِ الفشل، بل صمّم مخرجات تعلنه صراحة: لم يُكتشف وجه (Face not detected)، أو الوجه محجوب جزئيًا (Face partially occluded)، أو الثقة منخفضة (Low confidence)، أو الوضعية غير مدعومة (Unsupported pose)، أو لا قرار (No decision). فهذه كلها أفضل من تنبؤ عالي الثقة وغير موثوق.
مستقبل FER
لا يتجه المجال نحو "كاميرا تقرأ العقل"، بل نحو مسار تقني أكثر واقعية: نماذج أكثر متانة أمام الحجب ووضعية الرأس والإضاءة المنخفضة، ونماذج أخف تعمل على الجهاز نفسه، ونماذج زمنية تستثمر الديناميكيات بدل الإطار المنفرد، ودمج متعدد الوسائط يجمع الوجه والصوت والنص والفسيولوجيا. كما يتجه إلى وحدات الحركة والوجدان المستمر بدل الاكتفاء بسبع فئات، وإلى أنظمة واعية بعدم اليقين تعرف متى تمتنع عن القرار، وإلى معالجة تحافظ على الخصوصية محليًا وببيانات أقل.
العلاقة بالمقالات الأخرى
تتخصص هذه الصفحة في سؤال واحد:
كيف يحلل AI تعبير الوجه تقنيًا؟
أما الحوسبة العاطفية فأوسع، وتشمل الصوت والنص والإشارات الفسيولوجية والسياق. وأما نظام تخصيص المحتوى وفق التعبير فيبني طبقة فوق FER: يأخذ خرج التعبير ويصهره مع سياق المستخدم في محرك التوصيات، فيتحول القياس اللحظي إلى قرار تخصيص. وهذا البعد الإضافي وحده كافٍ لاعتباره نظامًا مختلفًا بمخاطر وحوكمة خاصة، ولهذا تبقى هذه المواضيع صفحات منفصلة بدل دمجها في مقال واحد ضخم.
الخلاصة
لا يقتصر التعرف على تعابير الوجه بالذكاء الاصطناعي على انتقال مباشر من الكاميرا إلى العاطفة، بل هو سلسلة هندسية متكاملة: تبدأ بالكاميرا، فاكتشاف الوجه، فاستخراج النقاط المرجعية والمحاذاة، ثم بناء representation بصرية داخل نموذج CNN أو Transformer أو نموذج AU، فاحتمالات التعابير، وأخيرًا درجات الثقة والسياق التي تحدد كيف سيُستخدم القرار فعليًا.
والفاصل الأهم في كل ذلك:
الوجه يقدم إشارات مرئية، والنموذج يقوم باستدلال احتمالي؛ لا توجد قناة تقنية تصل مباشرة إلى التجربة العاطفية الداخلية للإنسان.
ولذلك لا يُقاس النظام الجيد بدقته داخل Benchmark فقط، بل بإجابات واضحة عن أسئلة أعمق: ماذا يقيس بالضبط؟ هل بياناته ممثلة؟ كيف يعمل مع الحجب ووضعية الرأس؟ هل يتفاوت أداؤه بين المستخدمين؟ هل يعرف متى يكون غير واثق؟ ماذا يحدث للصور الخام؟ وهل حالة الاستخدام نفسها مناسبة قانونيًا وأخلاقيًا؟
وحين تُبنى FER بهذه الطريقة، تصبح أداة مفيدة للرؤية الحاسوبية والتفاعل بين الإنسان والآلة، بدل أن تتحول إلى ادعاء مبالغ فيه بأن الذكاء الاصطناعي "يقرأ المشاعر".
المصادر والمراجع
Lisa Feldman Barrett et al. — Emotional Expressions Reconsidered: Challenges to Inferring Emotion From Human Facial Movements
https://pubmed.ncbi.nlm.nih.gov/31313636/Goodfellow et al. — Challenges in Representation Learning: A report on three machine learning contests (FER2013)
https://arxiv.org/abs/1307.0414Lucey et al. — The Extended Cohn-Kanade Dataset (CK+)
https://ieeexplore.ieee.org/document/5543262Mollahosseini, Hasani, Mahoor — AffectNet: A Database for Facial Expression, Valence, and Arousal Computing in the Wild
https://arxiv.org/abs/1708.03985Li, Deng, Du — Reliable Crowdsourcing and Deep Locality-Preserving Learning for Expression Recognition in the Wild (RAF-DB)
https://openaccess.thecvf.com/content_cvpr_2017/html/Li_Reliable_Crowdsourcing_and_CVPR_2017_paper.htmlSariyanidi, Gunes, Cavallaro — Automatic Analysis of Facial Affect
https://doi.org/10.1109/TPAMI.2014.2330597Wang et al. — Region Attention Networks for Pose and Occlusion Robust Facial Expression Recognition
https://arxiv.org/abs/1905.04075FERMixNet — Occlusion Robust Facial Expression Recognition, IEEE Transactions on Affective Computing
https://ieeexplore.ieee.org/document/10663852/EU Artificial Intelligence Act — Regulation (EU) 2024/1689, Article 5
https://eur-lex.europa.eu/eli/reg/2024/1689/2026-07-27/engPicard — Affective Computing
https://mitpress.mit.edu/9780262661157/affective-computing/
وثائق رسمية ومعايير إضافية
الأسئلة الشائعة حول المقال
ما هو Facial Expression Recognition؟
هو تحليل آلي للحركات والأنماط المرئية على الوجه بهدف تصنيف تعبير ظاهر أو اكتشاف Action Units أو تقدير أبعاد مثل Valence/Arousal.
هل FER تقرأ المشاعر الحقيقية؟
لا. يمكنها تحليل إشارات وجهية وبناء تقدير احتمالي، لكن الشعور الداخلي يتأثر بالسياق والثقافة والشخص ولا يمكن استخراجه مباشرة من الوجه وحده.
ما الفرق بين Face Recognition وFER؟
Face Recognition تبحث عن هوية الشخص، بينما FER تحلل النمط التعبيري الظاهر على الوجه.
ما FACS؟
نظام لترميز حركات الوجه إلى Action Units. هو يصف الحركة المرئية ولا يثبت وحده شعورًا داخليًا محددًا.
ما Action Units؟
وحدات ترميز لحركات عضلية وجهية محددة، مثل رفع زوايا الفم أو خفض الحاجب.
ما FER2013؟
Dataset شائعة لتصنيف تعابير الوجه تحتوي على 35,887 صورة رمادية 48×48 موزعة على سبع فئات.
ما CK+؟
Dataset تحتوي على 593 sequence من 123 مشاركًا، و327 منها تحمل Labels عاطفية، وغالبًا تعرض انتقالًا من Neutral إلى Peak expression.
ما AffectNet؟
Dataset كبيرة جُمعت من الإنترنت وتضم أكثر من مليون صورة مجمعة، مع Manual annotations لجزء كبير منها ودعم للفئات وValence/Arousal.
ما RAF-DB؟
Dataset من 29,672 صورة في العالم الحقيقي مع Labels تم جمعها عبر عدة مقيمين، وتشمل تعبيرات أساسية ومركبة.
لماذا Accuracy داخل CK+ لا تكفي؟
لأن CK+ بيئة مخبرية مضبوطة نسبيًا، وقد ينخفض الأداء عند الانتقال إلى كاميرات وإضاءة ووجوه وزوايا مختلفة في العالم الحقيقي.
النقاش الهندسي والملاحظات (0)
سجّل الدخول للمشاركة في النقاش والرد على التعليقات والإعجاب بها.


