



تصنيف الصور (Image Classification) مهمة في الرؤية الحاسوبية تهدف إلى إسناد فئة أو أكثر إلى صورة كاملة اعتمادًا على محتواها المرئي. تدخل الصورة إلى النموذج، فيخرج منه توزيع من الدرجات على الفئات المعروفة، كأن يمنح فئة cat درجة 0.91، وفئة dog درجة 0.07، وفئة other درجة 0.02.
لكن بناء نظام تصنيف موثوق لا يبدأ باختيار شبكة عصبية. فالمسار الحقيقي منظومة متكاملة تبدأ قبل أول سطر من كود النموذج، وتحديدًا من البيانات: جمعها ثم تنظيفها ووسمها، وهي المرحلة التي تحدد سقف الأداء النهائي أكثر من أي قرار معماري لاحق، لأن ضجيج الوسم وتحيّز العينات ينتقلان مباشرة إلى سلوك النموذج. بعدها تُقسَّم البيانات إلى مجموعات تدريب وتحقق واختبار بفصل صارم يمنع تسرب المعلومات، ليبقى الاختبار مقياسًا صادقًا لأداء لم يُروَّض عليه النموذج. ثم تأتي المعالجة المسبقة والتعزيز، التي توحّد الأحجام والإضاءة وتولّد تنويعات اصطناعية تقلل اندفاع النموذج نحو حفظ أمثلة التدريب.
وبعد هذه التحضيرات فقط يُختار النموذج أو الـBackbone المدرَّب مسبقًا، ويخضع لـالتدريب أو الضبط الدقيق على بيانات المهمة. ولا ينتهي العمل عند أول دقة مرتفعة: فهناك مرحلة تقييم بمقاييس تراعي توازن الفئات، ثم معايرة الاحتمالات وتحليل الأخطاء لكشف أنماط الفشل الحقيقية بدل الاكتفاء برقم إجمالي. وأخيرًا يمر النظام إلى النشر والمراقبة المستمرة، لأن توزيع بيانات الإنتاج ينحرف تدريجيًا عن بيانات التدريب، فتصبح إعادة التدريب الدورية جزءًا من تصميم النظام لا إجراءً طارئًا.
وفوق ذلك كله تبقى حقيقة أساسية:
النموذج لا "يفهم" الصورة كما يفهمها الإنسان؛ بل يتعلم تمثيلات عددية تساعده على ربط أنماط بصرية بفئات محددة.
التصنيف وجيرانه: الكشف والتجزئة والتعرف على الوجوه
كثيرًا ما تُخلط مهام الرؤية الحاسوبية ببعضها، مع أن كلًا منها يطرح سؤالًا مختلفًا ويُخرج ناتجًا مختلفًا:
| المهمة | السؤال الذي تجيب عنه | الناتج |
|---|---|---|
| Image Classification | ما الموجود في الصورة؟ | فئة للصورة كاملة، مثل "قطة" |
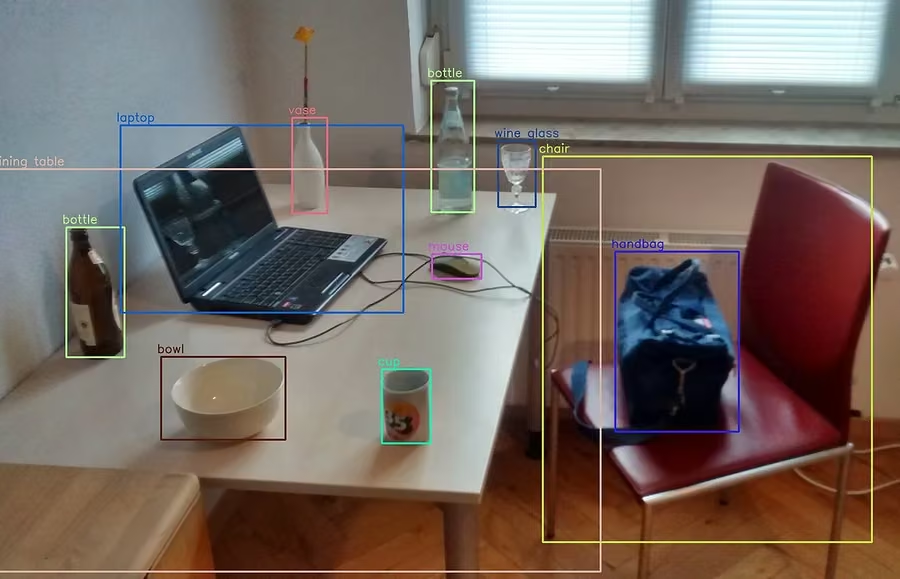
| Object Detection | ما الأشياء الموجودة، وأين توجد؟ | فئة وBounding Box ودرجة ثقة لكل جسم |
| Image Segmentation | أي Pixels تنتمي إلى أي كائن أو منطقة؟ | Mask على مستوى البكسل |
ففي Object Detection مثلًا قد يحدد النموذج شخصًا وسيارة وإشارة مرور في المشهد نفسه، ويرسم حول كل منها مربعًا محيطًا.
أما Face Recognition فليست مجرد تصنيف صور عام؛ فسؤالها غالبًا «هل هذا الوجه يعود إلى هوية معينة؟»، وهي تعتمد على تمثيلات ومطابقة هوية، وتحمل آثارًا مختلفة على الخصوصية والأمن. ولهذا لا ينبغي اعتبار نجاح Image Classifier دليلًا تلقائيًا على نجاح Object Detector أو نظام تعرف على الوجوه.
ويوضح مشروعنا نظام الكشف عن الأسلحة بالذكاء الاصطناعي هذا الفرق عمليًا: فهو لا يكتفي بتصنيف الإطار كاملًا، بل يستخدم YOLOv8 لتحديد مكان السكين أو المسدس داخل بث الكاميرا بإطار محيط. وأثناء بناء النظام لاحظنا أن تغيّر ظروف الإضاءة وزوايا ظهور الأجسام يؤثر مباشرة في جودة الكشف، وأن الموازنة بين سرعة المعالجة ودقة الكشف قرار هندسي يُتخذ في كل بيئة تشغيل على حدة.
كيف يرى الحاسوب الصورة؟
الصورة الرقمية في نظر الحاسوب مصفوفة قيم. فصورة RGB يمكن تمثيلها تقريبًا بأبعاد الارتفاع × العرض × 3 قنوات، ويحمل كل بكسل فيها قيمًا تمثل شدة الأحمر والأخضر والأزرق.
وقبل التعلم العميق، كان على المهندس أن يحوّل هذه القيم الخام إلى ميزات (Features) يصممها يدويًا، أما اليوم فتتعلم النماذج العميقة جزءًا كبيرًا من هذا التمثيل مباشرة من البيانات. وفهم هذا التحول هو مفتاح فهم تاريخ المجال كله.
من السمات اليدوية إلى الشبكات الالتفافية
المسار الكلاسيكي قبل التعلم العميق
كان المسار الكلاسيكي مرحليًا ويدويًا في صميمه. يبدأ باستخراج سمات مصممة يدويًا عبر مرشحات وخوارزميات هندسية صاغها باحثون بعناية، فتتحول البكسلات الخام إلى متجه سمات مضغوط يلخص ما اعتُبر مهمًا من حواف وزوايا وأنسجة، ثم يُغذَّى هذا المتجه إلى مصنف تقليدي يتعلم الحدود الفاصلة بين الفئات في فضاء السمات. وكانت جودة النظام كله رهينة براعة المهندس في تصميم السمات، فأي نمط لم يلتقطه الـdescriptor يضيع ببساطة قبل أن يبلغ المصنف.
ومن أشهر واصفات السمات HOG وSIFT وLBP وGabor features، ومن أشهر المصنفات التي استُخدمت معها SVM وLogistic Regression وKNN وRandom Forest.
مثال كلاسيكي: HOG + SVM
يلخص HOG اتجاهات التدرجات (Gradients) والحواف في الصورة ويحولها إلى Feature Vector، ثم يتعلم SVM حدًا يفصل بين الفئات. وما زالت هذه المنهجية مفيدة في بعض المشاريع، حين تكون البيانات قليلة، والمشكلة بسيطة نسبيًا، والحوسبة محدودة، والميزات معروفة جيدًا، ونحتاج نموذجًا صغيرًا وسريعًا. لكنها تظل أكثر اعتمادًا على هندسة الميزات يدويًا.
ماذا غيّرت CNN؟
جاءت Convolutional Neural Networks — CNNs لتسمح بتعلم الميزات أثناء التدريب نفسه. فبدل أن يصمم الإنسان الميزات ثم يمررها إلى مصنف، أصبحت الصورة تدخل مباشرة إلى شبكة تتعلم ميزاتها بنفسها ثم تصنفها.
وقلب هذه الشبكات هو الطبقة الالتفافية، التي تطبّق مرشحات (Kernels/Filters) على مناطق محلية من الصورة. وفي الطبقات المبكرة قد تظهر استجابات لأنماط بسيطة مثل الحواف والاتجاهات والتباينات والأنسجة (Textures)، ومع ازدياد العمق تصبح التمثيلات أكثر ارتباطًا ببنية الكائنات.
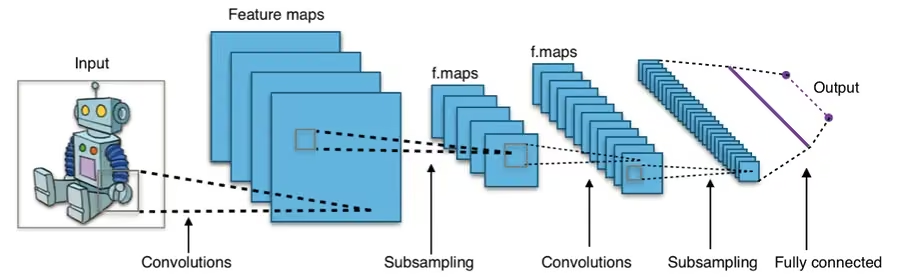
لكن ينبغي الحذر من العبارة المبسطة الشائعة: «الطبقة الأولى تتعرف على الحواف، والثانية على العيون، والثالثة على الوجه». فهي مفيدة تعليميًا، لكنها ليست قاعدة ثابتة لكل شبكة وكل Dataset.
Pooling: تقليص الأبعاد المكانية
يقلل Pooling الأبعاد المكانية لبعض خرائط الميزات (Feature Maps)، وأشهر أشكاله Max Pooling وAverage Pooling.
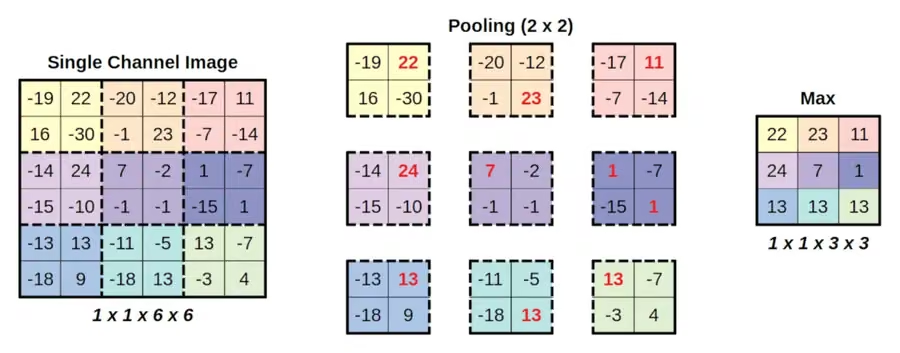
ويساعد ذلك على تقليل حجم الحساب، وزيادة مجال الاستقبال (Receptive Field) بصورة غير مباشرة، وجعل بعض التمثيلات أقل حساسية للتغيرات المحلية الصغيرة. لكن الشبكات الحديثة لا تعتمد جميعها على Pooling التقليدي بالطريقة نفسها، فبعضها يستخدم Strided Convolutions أو معماريات أخرى.
رأس التصنيف: ليس بالضرورة طبقات متصلة بالكامل
يُقال غالبًا إن كل CNN تنتهي بطبقات Fully Connected، وهذا وصف صحيح لكثير من المعماريات التقليدية لكنه ليس قاعدة عامة. فالنماذج الحديثة قد تستخدم Global Average Pooling، أو رأس تصنيف خطيًا (Linear classification head)، أو رؤوس انتباه (Attention heads). المفهوم الجوهري إذن هو وجود Classifier Head يحول التمثيل إلى درجات للفئات، لا ضرورة وجود عدة طبقات متصلة بالكامل.
ResNet: كيف أصبح التدريب العميق ممكنًا؟
مع ازدياد عمق الشبكات ظهرت مشكلة لافتة: الشبكات الأعمق لا تصبح أسهل في التدريب تلقائيًا. فقدمت ResNet فكرة Residual Connections، حيث تتعلم الطبقة الفرق المتبقي وتُضاف إليه المدخلات مباشرة:
بدل أن تتعلم كل طبقة تحويلًا كاملًا من الصفر. وقد ساعد هذا التصميم على تدريب شبكات عميقة جدًا، وفي ورقة ResNet الأصلية حقق Ensemble من الشبكات المتبقية خطأ 3.57% في مسابقة ImageNet 2015.
وهنا تلزم الدقة:
رقم 3.57% لا يعني أن أي ResNet منفردة حققت "96.43% Accuracy" على كل أنواع الصور، ولا يعني أن الذكاء الاصطناعي أصبح أفضل من البشر في الرؤية عمومًا.
إنه نتيجة Benchmark محدد، ضمن مقياس وبنية وتجربة محددة.
ما بعد CNN: المحولات ونماذج الأساس
ما تزال CNN قوية جدًا، لكن تصنيف الصور الحديث لم يعد قائمًا عليها وحدها، وكان Vision Transformer — ViT من أهم التحولات.
كيف تعمل Vision Transformer؟
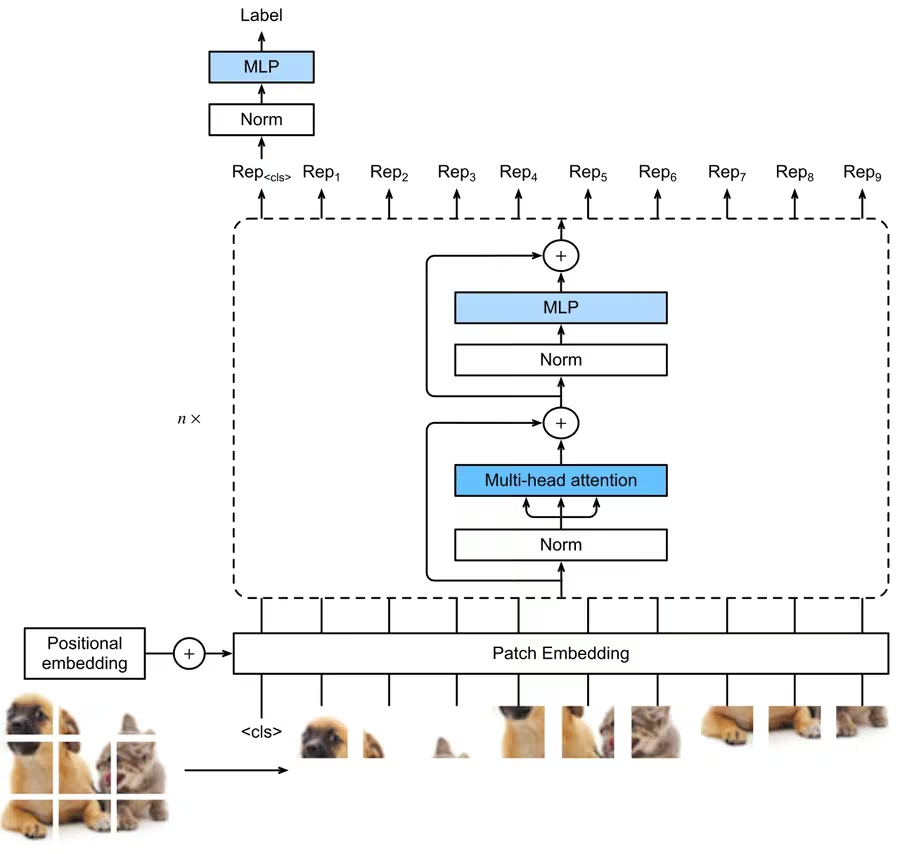
فكرة ViT الأصلية بسيطة مفاهيميًا: تُشرَّح الصورة إلى رقع صغيرة (Patches) بحجم 16×16 بكسل مثلًا، وتُسطَّح كل رقعة وتمر عبر إسقاط خطي لتصبح embedding في فضاء معالجة النموذج، تمامًا كما تتحول الكلمة إلى token في النماذج اللغوية. ثم تُعامل هذه الـembeddings كسلسلة tokens تعبر طبقات الـTransformer، حيث يسمح الانتباه الذاتي لكل رقعة بأن "تنظر" إلى جميع الرقع الأخرى وتقرر أيها ذو صلة بفهم المشهد كله. وفي النهاية تُستخدم الـrepresentation النهائية، غالبًا عبر token تصنيفي مخصص، لإسناد الصورة إلى فئتها.
وقد أظهرت ورقة ViT أن Transformer خالصًا يمكن أن يحقق أداء قويًا جدًا في تصنيف الصور عند تدريبه مسبقًا على بيانات كبيرة ثم نقله إلى Benchmarks أخرى. فاتسع المشهد من قناعة بأن CNN هي البنية الطبيعية الوحيدة للرؤية، إلى إدراك أن CNN وTransformers وغيرها قادرة جميعًا على تعلم تمثيلات بصرية فعالة.
هل Vision Transformer أفضل من CNN دائمًا؟
لا. فالاختيار رهن بحجم البيانات، وتوافر التدريب المسبق، والموارد، وزمن الاستجابة، والجهاز المستهدف، والدقة المطلوبة، وحجم النموذج. فقد تكون CNN صغيرة ممتازة لتطبيق على الحافة (Edge)، بينما يتفوق ViT أو Foundation Model حين يتوافر تدريب مسبق قوي أو نحتاج تمثيلًا أوسع. ولا توجد "أفضل Architecture" بمعزل عن حالة الاستخدام.
من الفئات المغلقة إلى المفردات المفتوحة
التصنيف التقليدي غالبًا Closed-set، أي أن الفئات معروفة أثناء التدريب، مثل cat وdog وhorse وcar، ورأس التصنيف يتعلم هذه الفئات وحدها. لكن نماذج الصورة والنص الحديثة مثل CLIP غيّرت طريقة التفكير.
CLIP: التصنيف عبر اللغة
تتعلم CLIP ربط الصور والنصوص داخل فضاء تمثيل مشترك. فبدل رأس تصنيف ثابت، يمكن مقارنة الصورة بعبارات نصية مثل "a photo of a cat" و"a photo of a dog" و"a photo of a bicycle"، ثم اختيار العبارة الأقرب إليها. وهذا ما أتاح ما يسمى Zero-shot classification على Benchmarks متعددة دون تدريب إشرافي مباشر على كل Dataset.
لكن ذلك لا يعني أن Zero-shot يناسب تلقائيًا كل تطبيق حساس، فالأداء يتوقف على الفئات، وصياغة الـPrompt، والمجال (Domain)، وتوزيع البيانات، والانحيازات الكامنة في بيانات التدريب المسبق.
DINOv2: ميزات بصرية دون وسوم
DINOv2 مثال على Self-supervised visual pretraining، حيث يتعلم النموذج ميزات بصرية عامة من صور كثيرة دون الاعتماد على وسوم تقليدية لكل صورة. ثم يمكن استخدام هذا التمثيل في مهام مختلفة، منها التصنيف والاسترجاع (Retrieval) والتنبؤ الكثيف (Dense prediction) والنقل (Transfer). ويعكس ذلك اتجاهًا محوريًا في الرؤية الحاسوبية:
بدل تدريب Model منفصل من الصفر لكل مشروع، نبدأ أكثر فأكثر من Visual Foundation Model ثم نكيفه للمهمة.
بناء خط التصنيف خطوة بخطوة
بعد استعراض المعماريات، نعود إلى المنظومة التي رسمناها في المقدمة لنبنيها مرحلة مرحلة.
الخطوة الأولى: حدد المهمة بدقة
أول قرار هو نوع التصنيف: هل هو Single-label Classification حيث تحمل كل صورة فئة واحدة، كأن تكون قطة أو كلبًا، أم Multi-label Classification حيث قد تحمل الصورة أكثر من وسم، كأن تحتوي شخصًا ودراجة وخوذة معًا؟ والفرق جوهري، لأن دالة الخسارة (Loss) ودالة التفعيل في المخرجات والمقاييس كلها تختلف بين الحالتين.
الخطوة الثانية: اجمع البيانات
عدد الصور وحده لا يكفي. فالأسئلة الحاسمة هي: هل تمثل الصور بيئة التشغيل الحقيقية؟ هل تشمل كاميرات مختلفة وإضاءات مختلفة وأعمارًا أو فئات مختلفة؟ هل تغطي الحالات النادرة والخلفيات المتنوعة؟ وهل الوسوم صحيحة أصلًا؟ فمئة ألف صورة منحازة قد تكون أسوأ من Dataset أصغر لكنها ممثلة للمشكلة.
الخطوة الثالثة: افصل التدريب والتحقق والاختبار
تُستخدم مجموعة Train لتحديث الأوزان، ومجموعة Validation لاختيار المعاملات الفائقة (Hyperparameters) ونقطة الحفظ (Checkpoint) والعتبة (Threshold) والنموذج نفسه، أما مجموعة Test فللتقييم النهائي وحده.
ومن أخطر الأخطاء هنا Data Leakage. ففي التصوير الطبي مثلًا، إذا توزعت صور متعددة للمريض نفسه بين التدريب والاختبار، قد يبدو الأداء أعلى بكثير مما هو فعليًا. ولذلك قد يكون التقسيم الصحيح على مستوى المريض أو الجهاز أو الموقع أو الفترة الزمنية، بحسب طبيعة المهمة.
الخطوة الرابعة: المعالجة المسبقة
قد تشمل المعالجة المسبقة تغيير الحجم (Resize)، والقص (Crop)، والتطبيع (Normalization)، وتحويل الألوان، وإزالة التشوهات. ولا يوجد تطبيع واحد صحيح للجميع؛ فإذا استخدمت نموذجًا مدربًا مسبقًا، فالأغلب أن عليك احترام المعالجة المسبقة التي تدرب عليها.
الخطوة الخامسة: تعزيز البيانات
قد يشمل تعزيز البيانات (Data Augmentation) القص العشوائي، والتدوير، والقلب، وتغيير الألوان (Color jitter)، والتمويه، والمحو العشوائي (Random erasing)، وتقنيات MixUp/CutMix في بعض المشاريع. وهدفه ليس "زيادة عدد الصور" فحسب، بل تعريض النموذج لتغيرات منطقية قد يصادفها وقت التشغيل.
ويصبح التعزيز خطرًا حين يغير معنى الوسم: فقلب صورة أشعة أو عضو طبي أفقيًا قد يغير الجهة التشريحية (Laterality)، والتدوير الكبير قد يكون غير واقعي لمستندات أو اتجاهات محددة. والقاعدة هنا:
Augmentation يجب أن تحفظ معنى الفئة، لا أن تكون عشوائية لمجرد زيادة البيانات.
الخطوة السادسة: اختر خط أساس
ابدأ بشيء بسيط: Logistic Regression على ميزات جاهزة، أو SVM، أو ResNet18 مدرب مسبقًا، أو نموذج من فئة MobileNet/EfficientNet، أو ViT صغير. فالهدف أن تعرف ما إذا كان أي تعقيد إضافي يضيف قيمة حقيقية.
الخطوة السابعة: النقل أم التدريب من الصفر؟
في كثير من المشاريع يكون Transfer Learning الخيار العملي، وله أسلوبان شائعان. الأول Fixed Feature Extractor، بتجميد معظم الـBackbone وتدريب رأس التصنيف وحده. والثاني Fine-tuning، بالانطلاق من أوزان مدربة مسبقًا ثم تحديث بعض طبقات النموذج أو كلها.
فالنقل لا يعني دائمًا «تجميد الطبقات الأولى وتدريب الطبقة الأخيرة فقط»؛ تلك طريقة واحدة بين طرق. وقد يكون الضبط الدقيق الكامل أفضل حين تتوافر بيانات كافية، ويكون المجال مختلفًا، ونستخدم معدل تعلم مناسبًا.
الخطوة الثامنة: افهم ماذا يُخرج النموذج
ينتج المصنف متعدد الفئات غالبًا قيمًا خامًا تسمى Logits، مثل [4.2, 1.1, -0.4]، ثم تحولها دالة Softmax إلى قيم مجموعها 1، مثل [0.94, 0.043, 0.017]. لكن ثمة تنبيه مهم:
Softmax score ليست بالضرورة Probability معايرة جيدًا.
فقد يكون النموذج مفرط الثقة (Overconfident)، ولذلك نحتاج في التطبيقات عالية المخاطر إلى Calibration بدل تفسير 0.94 كأنها ثقة حقيقية بنسبة 94%.
كيف نقيس أداء المصنف؟
الدقة الإجمالية وفخها
تُعرَّف الدقة (Accuracy) كالتالي:
وهي مناسبة حين تكون الفئات متوازنة نسبيًا وتكلفة الأخطاء متقاربة، لكنها قد تكون مضللة. خذ Dataset فيها 990 صورة سليمة و10 صور مرضية: النموذج الذي يقول "سليم" لكل صورة يحقق دقة 99%، ومع ذلك يبلغ Recall للحالات المرضية 0%، أي أنه فاشل تمامًا في الهدف الطبي.
Precision وRecall وF1
تجيب Precision عن سؤال: من بين ما توقعه النموذج إيجابيًا، كم كان صحيحًا؟
وتجيب Recall عن سؤال: من بين الحالات الإيجابية الحقيقية، كم اكتشف النموذج؟
أما F1 Score فهو المتوسط التوافقي بين المقياسين، ويفيد حين نحتاج توازنًا بينهما:
Macro أم Weighted F1؟
في التصنيف متعدد الفئات، يحسب Macro F1 قيمة F1 لكل فئة ثم يمنحها جميعًا وزنًا متساويًا، فيكون مفيدًا حين تكون الفئات النادرة مهمة. أما Weighted F1 فيزن كل فئة بعدد عيناتها، وقد يخفي بذلك أداءً سيئًا على فئة صغيرة.
مصفوفة الالتباس
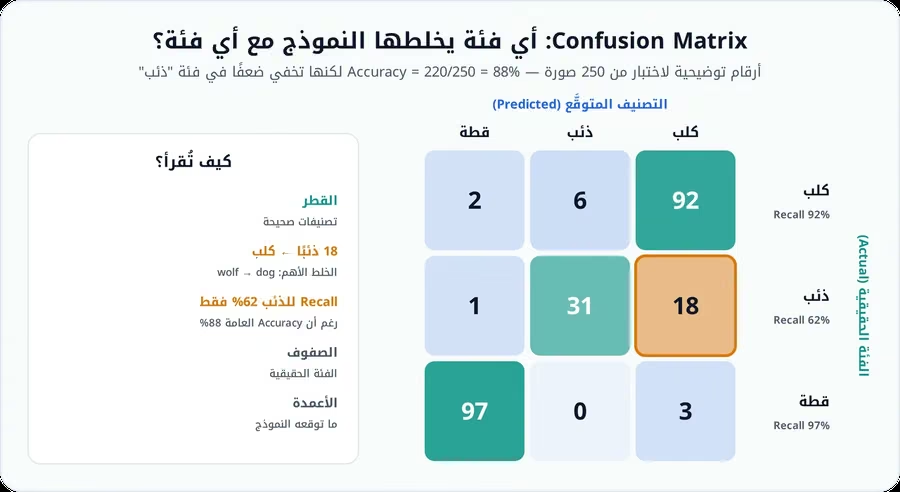
تُعد Confusion Matrix من أثمن الأدوات، لأنها تكشف أي فئة يخلطها النموذج مع أي فئة. فقد نكتشف أنه يخلط الذئب بالكلب، والشاحنة بالحافلة، والورم الميلانيني (melanoma) بآفة حميدة، وهذه المعلومات أهم بكثير من رقم دقة واحد.
ROC-AUC وPR-AUC
قد تفيد هذه المقاييس خصوصًا في التصنيف الثنائي، لكن اختيار المقياس يجب أن يستند إلى عدم توازن الفئات، وتكلفة الإيجابيات الكاذبة، وتكلفة السلبيات الكاذبة، والعتبة، وطبيعة التطبيق. وفي البيانات شديدة عدم التوازن قد يكون منحنى Precision-Recall أكثر إفادة من الدقة وحدها.
من الـDataset إلى العالم الحقيقي
انزياح التوزيع
النجاح على مجموعة الاختبار لا يكفي، لأن هناك مشكلة Distribution Shift. فقد يتدرب النموذج على صور كاميرات احترافية ثم يعمل على هاتف رخيص، أو يتدرب على بيانات مستشفى واحد ثم يُستخدم في مستشفى آخر، أو يتدرب في إضاءة جيدة ثم يعمل ليلًا. لذلك يجب اختباره على أجهزة ومواقع وأوقات مختلفة، وتحت التمويه وتغير الإضاءة والضغط والحجب الجزئي (Occlusion)، وعلى المجموعات الفرعية المهمة.
الثقة ليست يقينًا
قد يُخرج النموذج درجة 0.99 لفئة dog، بينما تكون الصورة خارج توزيع التدريب كليًا: صورة أشعة أمام نموذج مدرب على الحيوانات، أو رسمًا كرتونيًا غريبًا، أو نوع مرض لم يره من قبل. ولذلك تحتاج الأنظمة الجيدة أحيانًا إلى كشف ما هو خارج التوزيع (Out-of-distribution detection)، وإلى الامتناع عن الإجابة (Abstention)، والمراجعة البشرية، وعتبات الثقة، والمعايرة. فأفضل قرار قد يكون «لا أعرف بما يكفي» بدل فئة خاطئة بثقة كبيرة.
التعلم العميق أم التعلم الآلي التقليدي؟
كثيرًا ما تقارن المصادر الأكاديمية بين النهجين بحدة، لكن الواقع أكثر ارتباطًا بطبيعة المهمة:
| يُفضَّل التعلم الآلي التقليدي حين | يتفوق التعلم العميق غالبًا حين |
|---|---|
| تكون الـDataset صغيرة جدًا | تكون البيانات البصرية معقدة |
| تكون الميزات مفهومة وقوية | تتوافر نماذج مدربة مسبقًا |
| تكون الموارد محدودة | نحتاج إلى تعلم الميزات |
| يحتاج النموذج إلى البساطة | تكثر التغيرات البصرية |
| يكون زمن الاستجابة شديد الانخفاض | يكون النطاق كبيرًا |
| نحتاج تفسيرًا مباشرًا نسبيًا |
والأهم أن Transfer Learning قلّص كثيرًا الفجوة في متطلبات البيانات. فمقولة إن التعلم العميق يحتاج ملايين الصور دائمًا كانت أصح حين كان التفكير منصبًا على التدريب من الصفر؛ أما اليوم فيمكن الانطلاق من ResNet أو ViT مدرب مسبقًا، أو نموذج ذاتي الإشراف، أو نموذج صورة ونص، ثم ضبطه على Dataset أصغر. لكن "أصغر" لا يعني أن أي عدد من الصور يكفي، فالجودة والتمثيل والتشابه مع المجال الأصلي تظل عوامل حاسمة.
تطبيقات تصنيف الصور
التصوير الطبي
قد تساعد النماذج في قراءة صور الماموغرام، وصور الشبكية، والآفات الجلدية، وشرائح علم الأمراض، والأشعة السينية، والرنين المغناطيسي، والتصوير المقطعي. لكن يجب الفصل بين الأداء البحثي (Research performance) والنشر السريري (Clinical deployment).
فدراسة Nature عام 2020 عن فحص سرطان الثدي أظهرت، في Dataset الدراسة، انخفاضًا مطلقًا في الإيجابيات الكاذبة بمقدار 5.7% في الولايات المتحدة و1.2% في المملكة المتحدة، وانخفاضًا في السلبيات الكاذبة بمقدار 9.4% و2.7% على الترتيب. وهذه نتائج دراسة محددة، لا تصريحًا بأن "AI أدق من الأطباء في كل التشخيصات"، كما نُشر لاحقًا Addendum لزيادة تفاصيل قابلية إعادة إنتاج المنهج. ولهذا يحتاج أي نظام طبي إلى تحقق خارجي، وتحقق سريري، ومراجعة تنظيمية عند الاقتضاء، ومراقبة مستمرة، وإشراف بشري.
المركبات والقيادة الآلية
الرؤية الحاسوبية مهمة للمركبات، لكن Image Classification وحدها ليست كافية؛ فالمركبة تحتاج غالبًا إلى كشف الأجسام والتجزئة والتتبع وتقدير العمق ودمج الحساسات والتخطيط والتحكم.
كما يجب التعامل بحذر مع العبارة الشائعة «94% من الحوادث سببها الخطأ البشري». فوثائق NHTSA توضح أن "Critical Reason" هو آخر فشل في السلسلة قبل الحادث، وليس سبب الحادث ولا يعني إسناد الخطأ. ولا يصح بالتالي تحويل رقم كهذا إلى ادعاء بأن أنظمة الرؤية الآلية ستمنع تلقائيًا 94% من الحوادث.
التصنيع
يُستخدم التصنيف في تصنيف العيوب، وضبط جودة المنتج، والفرز، وتحديد نوع القطعة، ورصد حالات السطح. وفي أبسط صوره تلتقط الكاميرا صورة القطعة على خط الإنتاج، فيصنفها النموذج مباشرة إلى إحدى الفئات المعرّفة: سليمة، أو تحمل خدشًا، أو شقًا، أو تلوثًا سطحيًا، ويُبنى الحكم على عتبة ثقة تضبطها خطة الإنتاج. وهذا يكفي حين يكون السؤال «هل القطعة مقبولة؟»، أما إذا احتاجت المنشأة إلى تحديد مكان العيب وحدوده على السطح، فيصبح التصنيف أداة غير مناسبة، ويكون الانتقال إلى Detection أو Segmentation هو الحل الأنسب.
الزراعة
في الزراعة يُستخدم التصنيف لتحديد أمراض النباتات وأنواع المحاصيل ونضج الثمار وجودة المنتجات، لكن يجب اختبار النموذج على كاميرات مختلفة، وتحت ضوء الشمس، وفي بيئات مختلفة، وعلى أصناف نباتية متنوعة.
الأمن والمراقبة
يمكن استخدام التصنيف هنا لتصنيف المشاهد والمحتوى والأحداث المرئية. أما Face Recognition فمهمة مختلفة وحساسة، يجب فيها تقييم المطابقات الخاطئة، والأداء عبر الفئات السكانية، والموافقة أو الأساس القانوني، ومدة الاحتفاظ بالبيانات، وأمنها. ولا ينبغي اعتبار نموذج عالي الدقة على Dataset عامة دليلًا على ملاءمته لاستخدام هوية عالي المخاطر.
التحديات والمتانة وقابلية التفسير
تحديات البيانات والتعلم
تتعدد مصادر الفشل في أنظمة التصنيف، ويلخصها الجدول التالي:
| التحدي | ما يحدث |
|---|---|
| Label Quality | إذا كانت الوسوم خاطئة، يتعلم النموذج ضوضاء |
| Class Imbalance | قد يتجاهل النموذج الفئات النادرة |
| Shortcut Learning | يتعلم إشارة غير مقصودة، كعلامة جهاز أو خلفية أو Marker على الأشعة بدل المرض نفسه، ثم ينهار خارج الـDataset |
| Domain Shift | تغير الكاميرا أو الموقع أو السكان قد يخفض الأداء |
| Spurious Correlations | قد يرتبط الوسم بعامل جانبي في بيانات التدريب فقط |
الأمثلة العدائية
أظهرت الأبحاث أن اضطرابات (Perturbations) مصممة خصيصًا يمكن أن تدفع النماذج إلى تصنيف خاطئ بثقة عالية. لكن الهجمات العدائية ليست مجرد "ضوضاء غير مرئية"، فهناك أيضًا الأنماط العدائية الفيزيائية، وهجمات الرقع (Patch attacks)، وتسميم البيانات (Data poisoning)، والدفاع ضدها جميعًا ليس مشكلة محلولة بالكامل.
ويمكن للتدريب العدائي (Adversarial Training) أن يزيد المتانة ضد عائلات معينة من الهجمات، لكنه قد يرفع تكلفة التدريب، ويؤثر في الدقة على البيانات النظيفة، ولا يعمم على كل نموذج تهديد. ولذلك يجب أن يسبق اختيارَ الدفاع سؤالٌ واضح:
من المهاجم؟ وما قدرته؟ وما الذي نريد حمايته؟
كيف نفهم قرار النموذج؟
تستطيع أدوات مثل Grad-CAM إنتاج خريطة حرارية تقريبية للمناطق التي أسهمت في التنبؤ داخل بعض المعماريات القائمة على CNN. وهذا مفيد لتصحيح الأخطاء، واكتشاف Shortcut learning، ومراجعة ما ينظر إليه النموذج فعلًا. لكن:
Heatmap ليست تفسيرًا سببيًا كاملًا، ولا إثباتًا أن النموذج "فكر" بهذه الطريقة مثل الإنسان.
فأداة التفسير نفسها تحتاج إلى تقييم.
النشر على الأجهزة الطرفية
قد نحتاج إلى تشغيل التصنيف على هاتف، أو كاميرا، أو جهاز من فئة Raspberry Pi، أو مسرّع مدمج. ولهذا الغرض تتوافر عدة أدوات، يلخصها الجدول التالي:
| التقنية | الفكرة |
|---|---|
| Quantization | تقليل الدقة العددية، كالانتقال من FP32 إلى INT8 |
| Pruning | إزالة بعض الأوزان أو البنى قليلة الأهمية وفق طريقة محددة |
| Knowledge Distillation | تدريب Student model أصغر للاستفادة من Teacher أكبر |
| Smaller Backbone | أحيانًا يكون أفضل تحسين هو اختيار نموذج أصغر من البداية |
وأيًا كانت الأداة، يجب قياس الدقة، وزمن الاستجابة، والذاكرة RAM، وحجم النموذج، واستهلاك الطاقة، والإنتاجية، لا عدد FLOPs وحده.
كيف تغيّر نماذج الأساس مستقبل التصنيف؟
يشهد المجال انتقالًا من نموذج مدرب لفئات ثابتة فقط، إلى تمثيل بصري عام يمكن تكييفه لمهام كثيرة. فـCLIP يربط الصورة بالنص ويتيح Zero-shot classification في حالات كثيرة، وDINOv2 يتعلم ميزات بصرية عامة بأسلوب ذاتي الإشراف، والنماذج المدربة مسبقًا القائمة على ViT يمكن ضبطها أو استخدام ميزاتها مباشرة.
وتقلل هذه النماذج الحاجة إلى التدريب من الصفر، لكنها لا تلغي الحاجة إلى التحقق المحلي، واختبار التحيز، وحوكمة البيانات، واختبار المجال.
كيف تختار النهج عمليًا؟
يمكن الاسترشاد بالقرار المبسط التالي، الذي يربط طبيعة المشروع بنقطة البداية المناسبة:
| حالة المشروع | من أين تبدأ |
|---|---|
| Dataset صغيرة ومهمة واضحة | Pretrained CNN أو ViT مع Transfer Learning |
| جهاز Edge صغير | Mobile-oriented CNN، أو Small ViT، أو Quantized model |
| فئات تتغير باستمرار | Image-text models، أو Embedding-based classification، أو Retrieval-assisted approach |
| مجال طبي أو صناعي حساس | جودة الـDataset، والتحقق الخارجي، والمعايرة، وتحليل الأخطاء، والمراجعة البشرية، والمراقبة |
| لا توجد وسوم كافية | Self-supervised pretraining، أو Transfer Learning، أو Active Learning، أو Weak supervision، أو Vision-language models |
قائمة تحقق قبل إطلاق المصنف
قبل أن يصل المصنف إلى الإنتاج، ينبغي التأكد من النقاط التالية، موزعة على مراحل المنظومة:
| المرحلة | ما يجب التحقق منه |
|---|---|
| تعريف المهمة | المهمة Classification فعلًا وليست Detection/Segmentation، والفئات معرّفة بوضوح |
| البيانات | الوسوم راجعها مختصون عند الحاجة، ومجموعات Train/Val/Test منفصلة دون Leakage، ومجموعة الاختبار تمثل العالم الحقيقي |
| النمذجة | يوجد Baseline، وعولج عدم توازن الفئات بصورة مناسبة |
| التقييم | المقاييس مختارة وفق تكلفة الخطأ، ومصفوفة الالتباس رُوجعت، وتقييم المجموعات الفرعية موجود عند الحاجة |
| الموثوقية | النموذج معايَر إذا كانت الدرجات ستُستخدم كاحتمالات، وسلوكه خارج التوزيع معروف، ويوجد بديل بشري للقرارات الحرجة |
| التشغيل | زمن الاستجابة والطاقة والذاكرة اختُبرت على الجهاز الحقيقي، والمراقبة بعد النشر قائمة، وخطة إعادة التدريب والإصدارات جاهزة |
الخلاصة
لم يعد تصنيف الصور يعني صورة تدخل إلى CNN فتخرج منها فئة. فالنظام الحديث منظومة متكاملة تُبنى بالتراكم لا بخطوة واحدة: تبدأ بـبيانات ممثلة للتوزيع الحقيقي الذي سيواجهه النظام، وتمر عبر معالجة مسبقة وتعزيز يوسّعان تغطية التدريب، ثم تستفيد من representation بصرية مدرَّبة مسبقًا داخل CNN أو ViT أو Foundation Model بدل تعلم كل شيء من الصفر. يأتي بعدها الضبط الدقيق على بيانات المهمة، فتخرج درجات احتمالية لا تصنيفات جامدة، تخضع بدورها إلى معايرة ومقاييس وتحليل أخطاء يكشف نقاط الضعف قبل أن يكشفها المستخدم. وعند النشر لا تنتهي القصة، إذ ترصد المراقبة المستمرة انحراف البيانات وتدهور الأداء، وتغذي دورة تحسين تعود إلى البيانات من جديد.
وتاريخيًا قطع المجال رحلة طويلة: بدأ بالسمات المصممة يدويًا (Hand-crafted Features) المستخرجة بطرق مثل SIFT وHOG والمغذّاة إلى مصنف مثل SVM، ثم جاءت الشبكات العصبية الالتفافية (CNN) لتتعلم هذه السمات من البيانات نفسها، تلتها شبكات أعمق مثل ResNet، ثم Vision Transformer الذي قلّص الحاجة إلى الحجم الكبير من البيانات الموسومة عبر التدريب المسبق، حتى وصلنا اليوم إلى نماذج الأساس المدربة ذاتيًا ومتعددة الوسائط بصريًا ولغويًا. لكن النموذج الأحدث ليس تلقائيًا الأفضل.
فأفضل نظام هو الذي يحل المهمة الصحيحة، ويتدرب على بيانات ممثلة، ويُقاس بمقاييس تناسب المخاطر، ويعرف متى لا يثق بتوقعه، ويعمل ضمن حدود الموارد، ويثبت أداءه في البيئة التي سيُستخدم فيها فعلًا.
المصادر والمراجع
K. He et al. — Deep Residual Learning for Image Recognition
https://arxiv.org/abs/1512.03385A. Dosovitskiy et al. — An Image is Worth 16×16 Words: Transformers for Image Recognition at Scale
https://arxiv.org/abs/2010.11929OpenAI — CLIP: Connecting Text and Images
https://openai.com/index/clip/M. Oquab et al. — DINOv2: Learning Robust Visual Features without Supervision
https://arxiv.org/abs/2304.07193PyTorch — Transfer Learning for Computer Vision Tutorial
https://docs.pytorch.org/tutorials/beginner/transfer_learning_tutorialscikit-learn — Metrics and scoring: quantifying the quality of predictions
https://scikit-learn.org/stable/modules/model_evaluation.htmlS. M. McKinney et al. — International evaluation of an AI system for breast cancer screening
https://www.nature.com/articles/s41586-019-1799-6McKinney et al. — Addendum: International evaluation of an AI system for breast cancer screening
https://www.nature.com/articles/s41586-020-2679-9R. R. Selvaraju et al. — Grad-CAM
https://arxiv.org/abs/1610.02391I. Goodfellow, J. Shlens, C. Szegedy — Explaining and Harnessing Adversarial Examples
https://arxiv.org/abs/1412.6572NHTSA — Critical reason is not the cause of a crash / crash causation guidance
https://www.nhtsa.gov/sites/nhtsa.dot.gov/files/812023-heavy_truck_pre-crash_scenarios.pdfO. Russakovsky et al. — ImageNet Large Scale Visual Recognition Challenge
https://arxiv.org/abs/1409.0575C. Shorten, T. M. Khoshgoftaar — A survey on Image Data Augmentation for Deep Learning
https://journalofbigdata.springeropen.com/articles/10.1186/s40537-019-0197-0
وثائق رسمية ومعايير إضافية
الأسئلة الشائعة حول المقال
ما هو تصنيف الصور بالذكاء الاصطناعي؟
هو تدريب نموذج لإسناد فئة أو أكثر إلى صورة كاملة اعتمادًا على الأنماط التي تعلمها من بيانات سابقة.
ما الفرق بين تصنيف الصور واكتشاف الأجسام؟
التصنيف يعطي فئة للصورة، بينما Object Detection يحدد أيضًا مواقع الأجسام داخلها باستخدام Bounding Boxes أو تمثيل مكافئ.
هل CNN ما تزال مستخدمة؟
نعم. CNN ما تزال فعالة جدًا، خصوصًا في التطبيقات العملية وEdge، لكنها لم تعد البنية الوحيدة؛ Vision Transformers وFoundation Models أصبحت مهمة أيضًا.
ما Vision Transformer؟
نموذج يقسم الصورة إلى Patches ويعاملها كسلسلة Tokens تمر عبر Transformer لاستخراج تمثيل للتصنيف أو مهام بصرية أخرى.
هل يجب تدريب النموذج من الصفر؟
غالبًا لا. Transfer Learning أو Fine-tuning لنموذج مدرب مسبقًا يكون خيارًا عمليًا جدًا.
هل Accuracy كافية لتقييم النموذج؟
لا، خصوصًا مع Class Imbalance. يجب النظر أيضًا إلى Precision وRecall وF1 وConfusion Matrix ومقاييس تناسب تكلفة الأخطاء.
ما الفرق بين Precision وRecall؟
Precision تقيس كم Prediction إيجابي كان صحيحًا، بينما Recall تقيس كم حالة إيجابية حقيقية استطاع النموذج اكتشافها.
هل Softmax 90% تعني أن النموذج صحيح بنسبة 90%؟
ليس بالضرورة. Scores قد تكون غير معايرة، والنموذج قد يكون Overconfident؛ لذلك يمكن استخدام Calibration عند الحاجة.
ما Zero-shot Image Classification؟
هو تصنيف فئات لم يُدرّب النموذج عليها مباشرة بصيغة Supervised التقليدية، مثل استخدام Image-Text model لمقارنة الصورة بأوصاف الفئات.
ما CLIP؟
نموذج يتعلم تمثيلات مشتركة للصور والنصوص ويمكن استخدامه في Zero-shot classification ومهام أخرى تعتمد على التشابه بين الصورة والوصف.
النقاش الهندسي والملاحظات (0)
سجّل الدخول للمشاركة في النقاش والرد على التعليقات والإعجاب بها.


