



مشاركة الرحلات الذكية (Dynamic Ride-Pooling) نظام نقل عند الطلب يحاول دمج ركاب ذوي مسارات متوافقة داخل المركبة نفسها في الوقت الفعلي، مع موازنة أهداف متعارضة: تقليل انتظار الراكب، وتقليل انحرافه عن مساره، ورفع إشغال المركبة، وخفض المسافات الفارغة، وتحسين كفاءة الأسطول.
تبدو الفكرة بسيطة: راكب ينطلق من X متجهًا إلى Y، وراكب آخر ينطلق من نقطة قريبة نحو وجهة قريبة، فيتقاسمان المركبة نفسها، ويلبي مشوار واحد طلبين بدل اثنين. وهذا الدمج هو جوهر القيمة الاقتصادية والبيئية للنظام كله، وهو في الوقت نفسه مصدر تعقيده: فكل راكب إضافي يعني انحرافات إضافية عن المسار الأمثل وزمن انتظار أطول، فيتحول "التقاط زميل في الطريق" إلى معادلة دقيقة تُوفّق بين راحة كل راكب وكفاءة الأسطول.
لكن تنفيذ الفكرة على مستوى مدينة كاملة أبعد ما يكون عن "العثور على أقرب سيارة". فالنظام الحقيقي يحل مسألة تتغير كل ثانية: طلبات جديدة تصل باستمرار، ومركبات تتحرك، وركاب موجودون بالفعل داخل المركبات، وأزمنة سفر تتبدل مع المرور، ولكل راكب حد مقبول للانتظار والانحراف، والسعة محدودة، وبعض الطلبات لا يمكن دمجها دون الإضرار بجودة الخدمة، وكل قرار الآن يؤثر في موقع المركبة بعد دقائق وفي قدرتها على خدمة الطلب التالي.
ولهذا يقترب نظام مشاركة الرحلات الحديث من منصة تحسين لحظية تعمل بلا توقف: تستقبل الطلبات ومواقع المركبات وحالة المرور والقيود التشغيلية مدخلاتٍ تتجدد كل ثانية، وتدفعها إلى محرك مطابقة وتوجيه يولّد الرحلات المشتركة وقرارات إعادة توزيع الأسطول، ثم يعيد حساب كل شيء كلما تغيرت الحالة، وهو ما يحدث باستمرار. فالنظام لا "يحل" المسألة مرة واحدة، بل يعيش في دورة إعادة تحسين دائمة.
Ride-Hailing وRide-Pooling: فرق جوهري
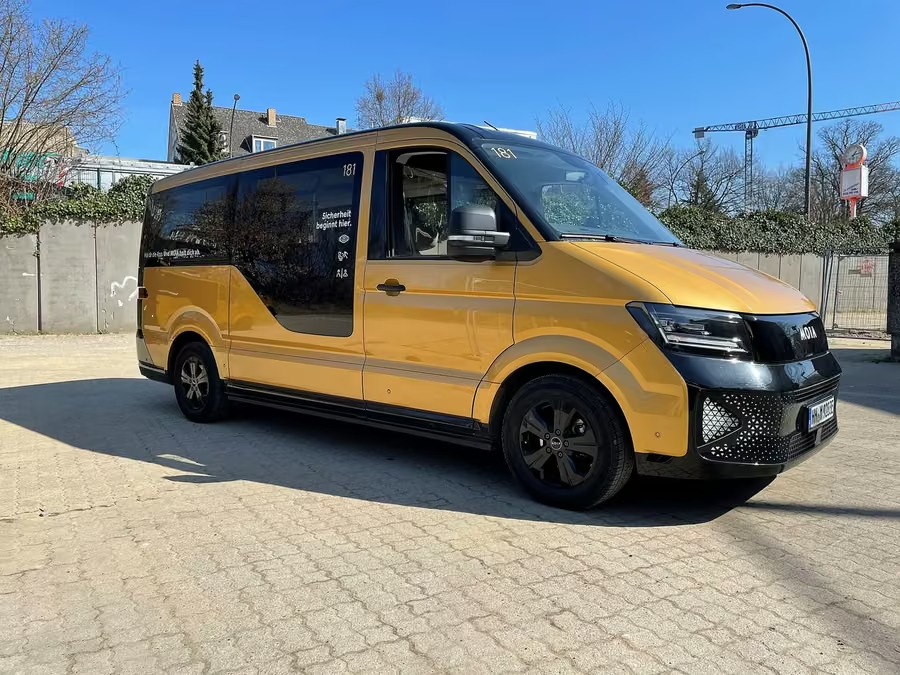
يُستخدم المصطلحان أحيانًا كأنهما شيء واحد، لكن الفرق بينهما حاسم. ففي Ride-Hailing تربط منصة رقمية بين راكب أو مجموعة واحدة وبين سائق أو مركبة، كرحلة خاصة عبر تطبيق: الراكب A في المركبة 1، والراكب B في المركبة 2، والراكب C في المركبة 3.
أما في Ride-Pooling فتحاول المنصة دمج طلبات مستقلة داخل المركبة نفسها إذا كانت متوافقة. فلكل من الركاب A وB وC نقطة انطلاق ووجهة مختلفة، لكن محرك المطابقة يفحص ما إذا كانت مساراتهم تتقاطع ضمن نطاق انحراف مقبول، فيسند الثلاثة إلى مركبة واحدة تخدمهم في جولة واحدة مرتبة بدل ثلاث جولات منفصلة. والتوافق هنا ليس قربًا جغرافيًا فحسب، بل يشمل أزمنة الالتقاط والنزول المسموحة وسعة المركبة، وهي القيود التي تفصل بين دمج ناجح وتجربة خدمة سيئة.
وتصف FHWA مشاركة الرحلة (ride-sharing) في بيئة النقل عند الطلب بأنها حالة يختار فيها الركاب منتجًا يسمح بمطابقة رحلاتهم مع ركاب آخرين لهم مسارات متداخلة.
والخلاصة:
كل Ride-Pooling هو نقل عند الطلب، لكن ليس كل Ride-Hailing مشاركة فعلية للرحلة.
وهذا الفرق أساسي حين يدور الحديث عن الازدحام والانبعاثات.
هل تقلل تطبيقات النقل الازدحام تلقائيًا؟
لا. قد تبدو الفكرة منطقية: إذا استخدم الناس سيارة لا يملكونها، فسيقل عدد السيارات. لكن النظام قد يضيف كيلومترات جديدة بسبب سير السيارة دون راكب بين الطلبات، وتوجهها إلى نقاط الالتقاط، وجذب أشخاص كانوا سيستخدمون الحافلة أو المترو أو المشي، وتوليد رحلات جديدة لم تكن لتحدث أصلًا. وتسمى المسافات التي تقطعها المركبة دون راكب Deadheading.
ففي دراسة شملت نحو 1.5 مليون رحلة لخدمة RideAustin، قُدّرت قيادة السائقين من منطقة العمل وإليها بما يعادل 19% من إجمالي المسافة المقطوعة للخدمة (VMT)، بينما شكلت القيادة بين الرحلات 26% أخرى وفق تقدير الدراسة. وهذه أرقام حالة دراسية محددة لا نسبة عالمية ثابتة. كما وجدت دراسة منشورة في Science Advances أن انتشار شركات النقل عند الطلب في سان فرانسيسكو أسهم في زيادة الازدحام خلال الفترة المدروسة بين 2010 و2016.
ولذلك:
النقل بالتطبيق ليس مرادفًا للنقل المشترك المستدام.
والسؤال الحقيقي هو:
هل النظام يزيد متوسط الإشغال ويقلل Vehicle Kilometers Traveled بعد احتساب المسافات الفارغة والانحرافات وتغير وسيلة النقل الأصلية؟
متى يمكن أن تقلل Ride-Pooling عدد المركبات؟
تتحقق الفائدة حين ينجح النظام في دمج طلبات كانت ستحتاج مركبات منفصلة. خذ ثلاثة ركاب A وB وC، يحتاج كل منهم في السيناريو التقليدي إلى مركبة خاصة تقطع 8 و7 و9 كيلومترات على التوالي، أي 24 مركبة-كيلومتر إجمالًا. فإذا دُمج الثلاثة في مركبة واحدة قطعت 13 كيلومترًا فقط، انخفض إجمالي المسافة المقطوعة بالمركبات (VKT) بنحو النصف.
لكن إذا كانت نقاط الالتقاط متباعدة، بحيث يبلغ الانحراف:
فقد تتلاشى الفائدة كليًا. فالنجاح رهن بكثافة الطلب، وتشابه نقاط الانطلاق والوصول، ونافذة الانتظار، والحد المقبول للانحراف، وحجم الأسطول، وسعة المركبات، وتوقيت الطلبات، وجودة المطابقة.
لماذا تُعد المشاركة الديناميكية مسألة صعبة؟
لنفترض وجود 5,000 مركبة، و20,000 طلب نشط، وعدة ركاب داخل بعض المركبات. لا يمكن عندئذ اختبار كل تركيبة ممكنة بطريقة ساذجة، فكل طلب جديد قد يُدرج قبل التقاط راكب آخر، أو بعده، أو بين عمليات إنزال، أو قد يُرفض. ويجب في كل حالة احترام القيود التالية:
| القيد | معناه |
|---|---|
| vehicle_capacity | سعة المركبة |
| maximum_wait_time | أقصى زمن انتظار |
| maximum_detour | أقصى انحراف عن المسار |
| pickup_time_window | نافذة زمن الالتقاط |
| dropoff_time_window | نافذة زمن الإنزال |
| driver_constraints | قيود السائق |
| service_area | منطقة الخدمة |
ولذلك ترتبط المشكلة بعائلات معروفة من المسائل، مثل التوجيه الديناميكي للمركبات (Dynamic Vehicle Routing)، ومسألة Dial-a-Ride، والإسناد (Assignment)، والتحسين التوافقي (Combinatorial Optimization)، وهي مسائل قد تصبح بالغة الصعوبة حسابيًا مع تزايد حجمها.
المسار الكامل لطلب الراكب
تمر رحلة الطلب داخل النظام بسلسلة مراحل لكل منها هدف مختلف. يدخل طلب الراكب فيُتحقق من صحته أولًا: إحداثيات سليمة، ومنطقة مغطاة، ومعطيات مكتملة. ثم يُبحث في الأسطول عن المركبات المرشحة القريبة والمتاحة، ويولّد المحرك فوقها الرحلات المشتركة الممكنة التي تحقق كل القيود، ويقدّر لكل خيار زمن الالتقاط وحجم الانحراف، ثم تُقيَّم البدائل بدالة هدف توازن بين رضا الركاب وكفاءة الأسطول، قبل أن تُسند المركبة ويُحدَّث مسارها. وبعد التنفيذ يواصل النظام تتبع الرحلة لحظة بلحظة، وحين تتغير الحالة، بطلب جديد أو ازدحام مفاجئ أو إلغاء، تُعاد الحسابات من جديد. فلا قرار يُتخذ مرة واحدة وينتهي، بل تبقى الرحلة كيانًا حيًا تُراجع خطته باستمرار.
استقبال الطلب
قد يحتوي الطلب النموذجي على موقع الالتقاط (pickup_location)، وموقع الإنزال (dropoff_location)، ووقت الطلب (request_time)، وأقصى انتظار مقبول (max_wait)، وأقصى انحراف مقبول (max_detour)، وعدد الركاب (passenger_count)، واحتياجات الإتاحة (accessibility needs). ولا ينبغي للنظام جمع بيانات إضافية لا يحتاجها.
البحث عن المركبات المرشحة
بدل مقارنة الطلب بكل مركبة في المدينة، يمكن تضييق البحث بحسب زمن الوصول المتوقع (ETA) إلى نقطة الالتقاط، والمنطقة الجغرافية، والسعة الشاغرة، واتجاه الرحلة الحالي، وإمكانية إدراج الطلب في المسار القائم. وهذه الخطوة تقلص مساحة البحث تقليصًا كبيرًا.
هل يمكن إدراج راكب جديد في رحلة قائمة؟
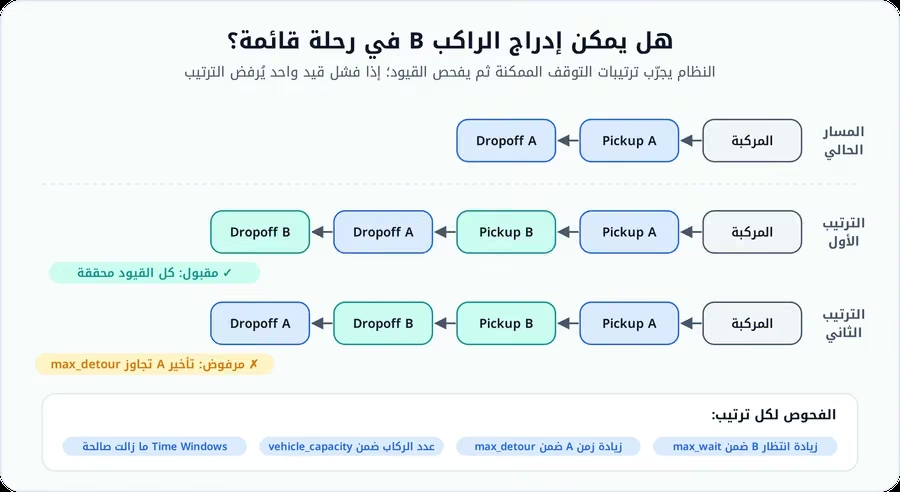
لنفترض أن المسار الحالي لمركبة يخدم الراكب A وحده: التقاطه ثم إيصاله. وحين يصل طلب جديد من الراكب B، لا يوجد ترتيب واحد صحيح لإدراجه؛ فقد يجرب النظام التقاط B قبل A ثم إنزاله بعده، أو التقاطهما معًا وإنزال B أولًا إن كانت وجهته أقرب. وفي كل احتمال يعيد النظام الحساب: كم سيزداد انتظار B؟ وكم سيزداد زمن رحلة A؟ وهل تُتجاوز السعة؟ وهل ما تزال النوافذ الزمنية صالحة؟ فإذا أخفق أي قيد، كان الطلب غير قابل للإدراج في هذه المركبة.
مخطط الطلب-الرحلة-المركبة (Request-Trip-Vehicle Graph)
من أشهر الأطر البحثية المؤثرة في المشاركة الديناميكية عمل Alonso-Mora وزملائه المنشور عام 2017، الذي يحل المسألة عبر أربع طبقات متراكبة: يحدد أولًا أي الطلبات قابلة للمشاركة أصلًا، ثم يبني الرحلات المشتركة الممكنة التي تحقق القيود الزمنية والمكانية، ثم يحسب توافق كل رحلة مع كل مركبة بوصفه نظامًا من الأزواج المقبولة، وأخيرًا يحل الإسناد الشامل الذي يوزع الرحلات على المركبات بأفضل قيمة إجمالية. وهذه الطبقات الأربع معًا هي ما يحوّل قائمة طلبات فوضوية إلى خطة تشغيل واحدة متماسكة.
وفي تجربة الدراسة على بيانات نحو 3 ملايين رحلة تاكسي في نيويورك، أظهر الباحثون أن خوارزمية المطابقة الديناميكية المبنية على هذا الإطار قادرة على تحقيق معدلات خدمة مرتفعة بأسطول أصغر في نموذج المحاكاة، مع مقايضة واضحة بين حجم الأسطول، وسعة المركبة، وزمن الانتظار، وتأخر الراكب. لكنها نتائج محاكاة على Dataset وسيناريو محددين، لا وعد بأن أي مدينة ستحصل على النسب نفسها.
لماذا لا نكتفي بالمطابقة الجشعة؟
تقول المطابقة الجشعة (Greedy): أعطِ الطلب لأقرب مركبة متاحة الآن. وهي سريعة وبسيطة وسهلة التشغيل، لكنها قد تنتج قرارًا سيئًا بعد خمس دقائق. فقد تكون المركبة A الأقرب إلى طلب صغير، بينما يظهر بعد دقيقة طلبان متوافقان جدًا في منطقة A نفسها؛ فإذا استُخدمت A الآن، فقد تضيع فرصة مشاركة أفضل لاحقًا. وهذا هو الفرق بين القرار قصير النظر (Myopic decision) والقرار الاستباقي (Anticipatory decision).
الخوارزميات المستخدمة في Ride-Pooling
لا توجد خوارزمية واحدة تصلح لكل منصة، بل عائلات من الأساليب لكل منها موقعها:
| العائلة | الفكرة | متى تناسب وما حدودها |
|---|---|---|
| Greedy / Insertion Heuristics | تختبر إدراج طلب جديد داخل مسار قائم | حين نريد السرعة، وBaseline قويًا، ونظامًا أبسط |
| Integer / Mixed Integer Optimization | صياغة الإسناد مسألة تحسين | حين نحتاج حلًا عامًا أفضل وقيودًا واضحة، لكن وقت الحساب قد يصبح تحديًا على نطاق كبير |
| Metaheuristics | مثل Large Neighborhood Search وGenetic Algorithms وSimulated Annealing | قد تجد حلولًا جيدة في مساحات بحث كبيرة، دون ضمان أن تكون أسرع أو أفضل في كل سيناريو |
| Machine Learning | يُستخدم في أجزاء من النظام بدل استبدال التحسين كاملًا | تقدير ETA، والتنبؤ بالطلب، واحتمال القبول، وزمن السفر، وتقليص المرشحين |
| Reinforcement Learning | يتعلم سياسات للقرارات طويلة الأمد | إعادة التوزيع، والتسعير، واختيار المناطق، والتحكم الاستباقي، لكنه ليس حلًا سحريًا لمسألة المطابقة |
وفي كثير من الأنظمة البحثية الأقوى يكون التصميم هجينًا: يتنبأ التعلم الآلي، ويقرر التحسين، وتقيّم المحاكاة. أو يُقسَّم العمل بين طبقتين: نموذج GNN أو RL يختار الإجراء الاستراتيجي، كأي منطقة تُعاد تغذيتها بالمركبات وأي سياسة مطابقة تُفعَّل، بينما يتولى solver الإسناد تطبيق القيود الصلبة دون تهاون: ألا تتجاوز المركبة سعتها، وألا يُخرق زمن التقاط أي راكب. وبهذا التقسيم يستفيد النظام من حدس التعلم دون أن يُسلَّم له قرار يخالف قيدًا تشغيليًا غير قابل للتفاوض.
لماذا تُستخدم الشبكات العصبية البيانية (GNN)؟
شبكة الطرق رسم بياني بطبيعتها: كل منطقة أو تقاطع عقدة (Node)، وكل طريق يربط بينهما حافة (Edge). ولهذا البناء ميزة جوهرية: فالطلب المرتفع في منطقة ما ينعكس خلال دقائق على المناطق المجاورة، وهو ما تلتقطه النماذج البيانية أفضل من النماذج التي تعامل كل منطقة وحدة معزولة. فتستطيع GNN بناء تمثيل للحالة يجمع طلب كل منطقة وعدد المركبات المتاحة فيها وأزمنة السفر وازدحام المناطق المجاورة، ثم تنتج Embeddings تمثل العلاقات المكانية بين هذه العناصر.
وعمليًا تُبنى المدينة كلها رسمًا بيانيًا حضريًا تمر شبكته عبر الـGNN فتنتج representation مكانية تلتقط العلاقات بين المناطق، وتغذي هذه التمثيلات بدورها طبقات التعلم المعزز أو التنبؤ أو التحسين التي تتخذ القرار الفعلي. فالـGNN هنا ليست صانعة قرار، بل صانعة فهم مكاني: تحوّل خريطة متفرقة من الأرقام إلى صورة مترابطة يبني عليها باقي النظام.
لكن استخدام GNN لا يعني تلقائيًا أن النموذج أفضل من الطرق التقليدية، بل يجب مقارنته بخطوط أساس تحت البيانات نفسها، والقيود نفسها، وميزانية الحوسبة نفسها، ومؤشرات الأداء نفسها.
ما دور التعلم التعزيزي العميق؟
في Ride-Pooling يؤثر القرار الحالي في المستقبل. فإرسال مركبة إلى غرب المدينة الآن قد يحقق مكافأة آنية أقل، لكن كثافة طلب مرتفعة قد تظهر هناك بعد عشر دقائق. ولهذا يحاول التعلم التعزيزي تعلم سياسة (Policy) تعظّم المكافأة على أفق زمني ممتد بدل قرار واحد. وتتكون صياغته من ثلاثة عناصر:
| العنصر | محتواه في Ride-Pooling |
|---|---|
| State | توزيع المركبات على المناطق، والطلبات النشطة، والطلب المتوقع خلال الدقائق القادمة، وحالة المرور، ونسبة إشغال المقاعد في كل مركبة |
| Action | إعادة تموضع مركبة نحو منطقة أخرى، أو تغيير منطقة تشغيلها، أو إعطاء أولوية لمجموعة طلبات، أو تعديل معامل في السياسة نفسها |
| Reward | يجمع ما يجب تعظيمه، كالرحلات المخدومة والإشغال، مع ما يجب تقليله: زمن الانتظار، والانحراف، والقيادة الفارغة، والطلبات المرفوضة، ومؤشر الانبعاثات |
لكن تصميم المكافأة بالغ الحساسية: فإذا أُعطي وزن كبير للإيرادات وحدها فقد يتجاهل النظام العدالة، وإذا أُعطي وزن كبير للإشغال فقد يفرض انحرافات مزعجة.
هل MADRL-GNN هي البنية المثالية؟
تقترح الحلقة البحثية الأصلية الدمج بين Multi-Agent Deep Reinforcement Learning + Graph Neural Networks، وهي فكرة منطقية بحثيًا، لأن المركبات متعددة، والشبكة رسم بياني، والقرارات متتابعة، والطلب متغير في الزمان والمكان. لكن لا ينبغي تحويل ذلك إلى القول بأن:
MADRL-GNN هي أفضل خوارزمية مثبتة لمشاركة الرحلات.
فالمقارنة العادلة تحتاج تنفيذًا مكتملًا، وخطوط أساس، وضبطًا للمعاملات الفائقة، وتشغيلًا بعدة بذور عشوائية (Seeds)، ومجموعات بيانات حقيقية، ودراسات حذف (Ablation studies)، ودلالة إحصائية، وحسابًا لتكلفة الحوسبة، واختبارات خارج التوزيع.
كما أن القول بأن الاستدلال بعد التدريب يصبح O(1) ليس صحيحًا عمومًا؛ فكلفة GNN تعتمد على عدد العقد والحواف والطبقات وحجم الميزات، وكلفة solver الإسناد تعتمد على عدد المركبات والطلبات والرحلات الممكنة والقيود.
إعادة توزيع الأسطول (Fleet Rebalancing)
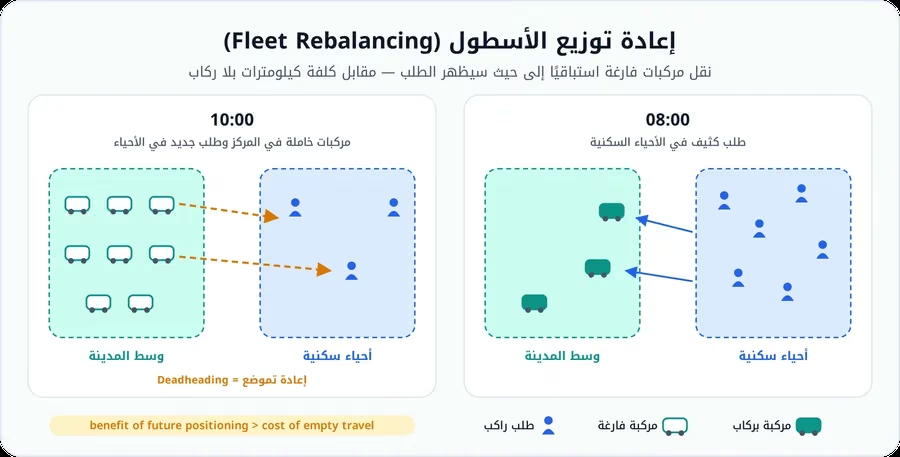
حتى لو كانت المطابقة ممتازة، قد يتجمع الأسطول في المكان الخطأ. ففي الثامنة صباحًا تنهال الطلبات من الأحياء السكنية، فتنقل المركبات ركابها إلى وسط المدينة، فلا يبقى في الأحياء لاحقًا إلا القليل منها. وبحلول العاشرة تتكدس المركبات الفارغة في المركز، بينما يظهر طلب جديد في الأحياء. وهنا تأتي إعادة التوزيع: توجيه المركبات الفارغة استباقيًا نحو حيث سيظهر الطلب.
لكن في ذلك مفارقة:
إعادة التموضع تساعد على تقليل الانتظار، لكنها تضيف Deadheading.
ولذلك يجب أن تفوق فائدة التموضع المستقبلي كلفة السير بلا ركاب.
كيف نتنبأ بالطلب؟
المدخلات والنماذج
يحاول التنبؤ بالطلب (Demand Forecasting) تقدير عدد الطلبات في كل منطقة وفي كل وقت، اعتمادًا على الطلب التاريخي، وساعة اليوم، ويوم الأسبوع، والطقس، والفعاليات، والعطلات، واضطرابات النقل العام، واتجاه الطلب الحالي. ويمكن استخدام نماذج السلاسل الزمنية، وGradient boosting، وLSTM/GRU، وTemporal CNN، وGNN، وTransformers. لكن لا يوجد "معيار ذهبي" واحد؛ فالنموذج الأفضل يتوقف على مجموعة البيانات، ودقة التقسيم المكاني، وأفق التنبؤ، وديناميكيات المدينة.
هل أفق 15–45 دقيقة مناسب دائمًا؟
لا. فأفق التنبؤ يجب أن يُختار بحسب القرار التشغيلي الذي يخدمه:
| أفق التنبؤ | القرار الذي يخدمه |
|---|---|
| 5 دقائق | إعادة التوزيع قريبة المدى |
| 30 دقيقة | تموضع الأسطول |
| ساعات | التوظيف والشحن وتخطيط العرض |
والأهم ليس دقة التنبؤ وحدها؛ فقد يكون نموذج أقل دقة أقدر على قيادة قرارات أفضل للأسطول. ولذلك يجب قياس Operational value of forecast، لا RMSE وحده.
بنية منصة Ride-Pooling حقيقية
المسار اللحظي والمسار غير اللحظي
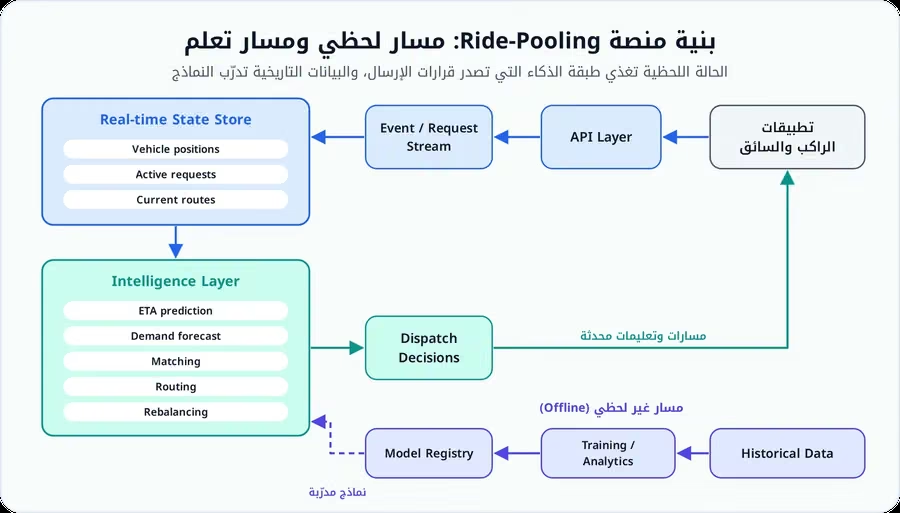
تُصمم المنصة طبقيًا انطلاقًا من طرفي التجربة: تتصل تطبيقات الراكب والسائق بطبقة API تلتقط الطلبات وتحديثات المواقع، فيتدفق كل ذلك عبر مجرى أحداث وطلبات لا يتوقف، ويتراكم في مخزن الحالة اللحظية الذي يحتفظ بلقطة حية للنظام: مواقع كل المركبات، والطلبات النشطة، والمسارات الجارية. وفوق هذا المخزن تعمل طبقة الذكاء التي تنتج تنبؤات ETA وتنبؤات الطلب وتتولى المطابقة والتوجيه وإعادة التوزيع، فتصدر قرارات الإرسال التي تعود إلى تطبيقات السائق والراكب لتُنفذ على الطريق. وهكذا تكتمل الدورة من التطبيق إلى التطبيق، وكل حلقة فيها تستهلك خرج الحلقة السابقة.
وبجانب هذا المسار اللحظي يسير مسار غير لحظي موازٍ: تتجمع البيانات التاريخية لتغذية التدريب والتحليلات، وتُخزَّن النماذج الناتجة في سجل النماذج الذي يدير إصداراتها ونشرها في الإنتاج. والفصل بين المسارين مقصود؛ فالنظام اللحظي يجب أن يستجيب في أجزاء من الثانية، بينما يجري التحسين من بيانات الأمس على إيقاع الأيام، ولكل مسار بنية تحتية مختلفة تمامًا.
هل نحتاج Big Data فعلًا؟
ليس كل نظام يحتاج "Big Data". فمنصة صغيرة في مدينة محدودة قد تعمل بكفاءة بقاعدة بيانات جغرافية، ومعالجة تدفقات بسيطة، وخدمة تحسين. ويكتسب مصطلح Big Data معناه حين يبلغ الحجم أو السرعة أو التنوع حدًا يستلزم معمارية موزعة فعلًا. فالهدف ليس «استخدام Kafka وData Lake لأن النظام ذكي»، بل بناء أبسط معمارية تستطيع تحقيق اتفاقية مستوى الخدمة (SLA) المطلوبة.
ما البيانات التي يحتاجها النظام؟
| المصدر | البيانات |
|---|---|
| الراكب | نقطة الانطلاق، والوجهة، ووقت الطلب، وعدد الركاب، وتفضيل أقصى انتظار، واحتياجات الإتاحة عند الحاجة |
| المركبة | الموقع الحالي، والمسار، والمقاعد المشغولة، والسعة، والحالة، ومستوى الطاقة أو الوقود إن كان مهمًا |
| الشبكة | أزمنة السفر، والإغلاقات، والحوادث، والازدحام |
| البيانات التاريخية | الطلب حسب المنطقة والوقت، والإلغاءات، وأزمنة الانتظار، ونجاح الالتقاط، والانحرافات، والقيادة الفارغة |
مطابقة الخريطة (Map Matching)
لا يعطي GPS دائمًا موقعًا دقيقًا على الطريق؛ فقد تظهر النقطة على بعد عشرة أمتار بجانبه. ولهذا تربط مطابقة الخريطة بيانات التتبع بأقرب مقطع منطقي في شبكة الطرق، وهي خطوة مهمة لأن تحسين المسارات يعتمد على رسم بياني صحيح.
هل الحوسبة الطرفية ضرورية؟
ليس دائمًا. فكثير من أنظمة Ride-Pooling يعمل عبر السحابة أو مراكز البيانات، لأن قرار الإرسال مركزي بطبيعته. وقد تفيد الحوسبة الطرفية في معالجة المرور محليًا، وترشيح البيانات لحماية الخصوصية، وأنظمة المركبات المتصلة، والتحليلات منخفضة الزمن على جوانب الطرق. لكن وضع "AI داخل كل مركبة" ليس شرطًا للمشاركة الديناميكية.
كيف نحدد دالة الهدف؟
قد يحقق نظام سيئ التصميم مؤشرًا واحدًا ويضر بالبقية. فتقليل المسافة المقطوعة وحده قد يُطيل انتظار الركاب، وتقليل الانتظار وحده قد يرسل مركبات كثيرة منفصلة، وزيادة الإشغال وحده قد تفرض انحرافات كبيرة. ولذلك نحتاج تحسينًا متعدد الأهداف (Multi-objective Optimization)، ومن أمثلته المبسطة:
والأوزان هنا ليست "قيمًا علمية ثابتة"، بل تعبير عن السياسات وأهداف الأعمال، ويجب اختبار حساسية النتائج لها.
مؤشرات الأداء الصحيحة
خمس عائلات من المؤشرات
| العائلة | المؤشرات |
|---|---|
| تجربة الراكب | متوسط الانتظار، وP90/P95 للانتظار، والزمن داخل المركبة، وزمن الانحراف، ومعدل الإلغاء، ومعدل الرفض، وموثوقية الالتقاط |
| الأسطول | إشغال المركبات، ومعدل المشاركة، ومسافة القيادة الفارغة، والكيلومترات المدرّة للدخل، وزمن الخمول، والرحلات لكل ساعة تشغيل |
| الشبكة | إجمالي VKT، وVHT، ومتوسط السرعة، وتأخير الازدحام |
| الاستدامة | استهلاك الوقود أو الطاقة، وCO₂e، والانبعاثات لكل راكب-كيلومتر |
| العدالة | زمن الانتظار حسب المنطقة، والرفض حسب المنطقة، وتغطية الخدمة، والإتاحة |
ومؤشرات العدالة تحديدًا هي ما يمنع النظام من تحسين وسط المدينة وحده وترك الأطراف بخدمة سيئة.
لماذا يكون P95 أهم من المتوسط أحيانًا؟
قد يبدو متوسط انتظار قدره 4 دقائق ممتازًا، لكن إذا كان 10% من المستخدمين ينتظرون 18 دقيقة أو أكثر، فثمة مشكلة حقيقية. ولذلك راقب التوزيع كاملًا، لا المتوسط وحده.
كيف نقيس الازدحام؟
لا يكفي حساب عدد المركبات التي وفرناها نظريًا. بل يجب استخدام المسافة المقطوعة بالمركبات (VKT)، وساعات السير (VHT)، وساعات التأخير (VHD)، والسرعة، وطول الطوابير، وإنتاجية الشبكة. كما يجب أن يشمل الحساب كل أنواع السير: السير بركاب، والقيادة الفارغة نحو الالتقاط، والقيادة الفارغة بين الرحلات، وإعادة التوزيع، والانحرافات.
الانبعاثات: الصورة الكاملة
هل تقلل Ride-Pooling الانبعاثات دائمًا؟
لا. فالفائدة البيئية حصيلة معادلة: السير الذي جرى تفاديه، مطروحًا منه القيادة الفارغة الجديدة، وانحرافات المشاركة، وأثر تغيير وسيلة النقل. فإذا انتقل شخص من سيارة خاصة إلى رحلة مشتركة، قد تظهر فائدة. أما إذا انتقل إليها من المترو أو الحافلة أو المشي أو الدراجة، فقد تزيد الطاقة المستهلكة والانبعاثات.
وهذا ما يفسر تباين النتائج في الأدبيات بين المدن. فالمراجعات المنهجية تشير إلى أن للمشاركة إمكانات كبيرة لخفض المسافة المقطوعة والطاقة، لكن النتائج الفعلية تتوقف على نسبة المشاركة الحقيقية، والإشغال، والقيادة الفارغة، وتغير وسائل النقل، وشكل المدينة، وشبكة النقل العام.
المؤشر البيئي الأهم: الانبعاث لكل راكب-كيلومتر
قد تكون مقارنة CO₂ لكل مركبة مضللة، والأفضل في حالات كثيرة استخدام CO₂e لكل راكب-كيلومتر؛ فمركبة تحمل ثلاثة ركاب قد تستهلك أكثر قليلًا من مركبة تحمل راكبًا واحدًا، لكنها توزع استهلاكها على عدد أكبر من الركاب. ومع السيارات الكهربائية يجب أيضًا تحديد نطاق القياس: انبعاثات العادم، أو توليد الكهرباء، أو انبعاثات دورة الحياة كاملة.
ماذا عن المشاركة بالمركبات الكهربائية؟
قد تقلل كهربنة الأسطول الانبعاثات التشغيلية بحسب مزيج توليد الكهرباء، لكنها تضيف قيودًا جديدة: حالة شحن البطارية، ومواقع الشواحن، وزمن الشحن، وطوابير الشواحن، والاحتياطي المطلوب في البطارية. فيتحول التحسين إلى مسألة تجمع إسناد الركاب والتوجيه وإعادة التوزيع والشحن معًا. وقد يكون إرسال مركبة كهربائية بعيدة إلى طلب ما قرارًا سيئًا إذا أدى إلى توقف لاحق للشحن.
المحاكاة: كيف نثبت أن النظام مفيد؟
حين لا تتوافر بيانات تشغيل حقيقية، تصبح المحاكاة أداة أساسية. لكن يجب الوضوح في حدودها:
المحاكاة دليل تجريبي داخل نموذج، وليست إثباتًا تلقائيًا لأداء مدينة حقيقية.
استخدام SUMO
يدعم SUMO محاكاة النقل المستجيب للطلب (Demand Responsive Transport) عبر Taxi Device، ويتضمن توثيقه الحالي خوارزميات إرسال مثل greedy وgreedyClosest وgreedyShared وrouteExtension، إضافة إلى الإرسال المخصص عبر TraCI. وهذا يجعله مناسبًا لبناء خط أساس واختبار خوارزمية خارجية.
تصميم تجربة جيدة
تقوم التجربة الجيدة على مقارنة متدرجة بين سيناريوهات واضحة:
| السيناريو | وصفه |
|---|---|
| Baseline A: Private Trips | مركبة منفصلة لكل طلب |
| Baseline B: Ride-Hailing | مركبة لكل طلب مع احتساب القيادة الفارغة |
| Baseline C: Greedy Pooling | مشاركة بسيطة |
| Model D: Advanced Optimization | الخوارزمية موضوع المقارنة |
ثم تُثبَّت ظروف المقارنة: الطلب نفسه، والشبكة نفسها، وافتراضات زمن السفر نفسها، وسعة المركبة نفسها، والحدود القصوى نفسها للانتظار والانحراف.
لا تقارن الذكاء الاصطناعي بخوارزمية ضعيفة عمدًا
من الأخطاء البحثية الشائعة مقارنة نموذج ذكاء اصطناعي بخط أساس ساذج من نوع "أقرب سيارة"، ثم إعلان أن الذكاء الاصطناعي "أفضل بكثير". فالمقارنة الجادة تتطلب خطوط أساس قوية، مثل insertion heuristic، والإسناد القائم على التحسين، وإعادة التوزيع التنبؤية، وخوارزميات مشاركة راسخة؛ وإلا فلن نعرف هل جاء المكسب من "الذكاء الاصطناعي" أم من ضعف المقارنة.
دراسة الحذف (Ablation Study)
إذا كان النظام يجمع التنبؤ بالطلب وGNN والتعلم التعزيزي وإعادة التوزيع، فيجب اختباره مرة دون التنبؤ، ومرة دون GNN، ومرة دون التعلم التعزيزي، ومرة دون إعادة التوزيع، حتى نعرف أي مكون أضاف القيمة فعلًا.
الاختبار بعدة بذور عشوائية
بيئة المرور عشوائية بطبيعتها، وتشغيل المحاكاة مرة واحدة لا يكفي. بل يجب استخدام عدة بذور عشوائية، وفترات ثقة، واختبارات إحصائية عند الحاجة. فلا يصح القول «خفضنا الازدحام 27%» إذا كان الرقم ناتجًا عن تشغيل واحد.
سيناريوهات الضغط
| السيناريو | السؤال الذي يطرحه |
|---|---|
| زيادة الطلب 20% | هل ينهار النظام؟ |
| حادث مروري | هل يعيد التوجيه؟ |
| مطر أو ذروة فعالية | هل يتكيف التنبؤ؟ |
| ضوضاء GPS | هل تبقى مطابقة الخريطة مستقرة؟ |
| نقص السائقين | هل يرتفع الرفض بصورة عادلة؟ |
| تأخر الاتصالات | هل تبقى القرارات صالحة؟ |
مشكلة معدل الرفض
يستطيع النظام تحسين متوسط الانتظار برفض الطلبات الصعبة: يخدم طلبات وسط المدينة السهلة، ويرفض الطلبات البعيدة، فتبدو المؤشرات جيدة. ولذلك يجب مراقبة الطلب المخدوم، والرفض، والتوزيع الجغرافي، وفئات الركاب معًا.
العدالة والخصوصية والأمن
العدالة في Ride-Pooling
قد يتعلم التحسين أن بعض المناطق "أقل ربحية"، فإذا لم توضع قيود مناسبة، قد تحظى المنطقة المركزية بخدمة ممتازة بينما يرتفع الرفض في الأطراف. ويمكن إضافة حد أدنى لتغطية الخدمة، وحد أقصى للتفاوت الجغرافي، وعقوبات للإخلال بالعدالة، ومؤشرات أداء على مستوى المناطق. لكن العدالة ليست وزنًا واحدًا في معادلة؛ بل تحتاج تعريفًا واضحًا لما يعنيه الإنصاف في سياق المدينة.
الخصوصية: بيانات الحركة حساسة
يعرف نظام المشاركة عادة أين تبدأ الرحلة وأين تنتهي، ومتى يتحرك الشخص، وتكرار زياراته، وأنماط حياته. وحتى بعد حذف الاسم، قد تبقى آثار الحركة (Mobility traces) قابلة لإعادة التعرف في بعض الظروف. ولذلك تلزم مجموعة من الضمانات:
| الضمانة | تطبيقها |
|---|---|
| Data Minimization | لا تجمع ما لا تحتاجه |
| Retention Limits | لا تحتفظ بالمواقع عالية الدقة إلى الأبد |
| Access Control | افصل بين العمليات الحية والتحليلات ومجموعات البيانات البحثية |
| Aggregation | التنبؤ على مستوى المنطقة قد لا يحتاج المسار الخام لكل مستخدم |
| Pseudonymization | مفيدة، لكنها ليست ضمانًا كاملًا لإخفاء الهوية |
الأمن
قد يتحكم النظام في آلاف المركبات، ولذلك يجب حماية الواجهات البرمجية، وتطبيقي السائق والراكب، ومحرك الإرسال، وصلاحيات الإدارة، وبيانات تتبع GPS، ونقاط وصول النماذج. ومن المخاطر المحتملة الطلبات الوهمية، وتزييف GPS، والاستيلاء على الحسابات، والتلاعب بالمسارات، وهجمات حجب الخدمة، وتسرب البيانات.
هل يمكن للذكاء الاصطناعي نفسه أن يسبب ازدحامًا؟
نعم. فإذا تنبأ نموذج بأن المنطقة A ستصبح ساخنة، فأعاد إليها 500 مركبة تتصرف كلها بالطريقة نفسها، فالنتيجة ازدحام ناتج عن إعادة التوزيع ذاتها (Rebalancing congestion). ولهذا يجب أن يكون التحكم واعيًا بالسعة، وواعيًا بالشبكة، ومنسقًا؛ فالتنبؤ الممتاز وحده لا يكفي.
السياق الأوسع: النقل العام والتسعير والمستقبل
العلاقة مع النقل العام
لا يجب أن يحاول أفضل نظام مشاركة استبدال المترو أو الحافلة أو الترام، فقد تكمن قيمته الأكبر في الميل الأول والميل الأخير، وساعات الطلب المنخفض، والمناطق ضعيفة الخدمة. فأفضل استخدام للمشاركة تغذية محاور النقل العام: رحلات قصيرة تجمع الركاب من أحيائهم إلى Transit Hub حيث يستقلون المترو أو BRT أو القطار، بدل رحلة مشتركة واحدة بطول 40 كم تعبر المدينة كلها. ففي هذا النمط تختص المركبات المشتركة بما تتفوق فيه، أي المرونة والوصول إلى الأبواب، وتترك للنقل الجماعي السريع ما يتفوق فيه، فيكون الناتج نظامًا متكاملًا أقل كلفة وأكثر استدامة. فالدمج مع النقل العام قد يكون أكثر استدامة من منافسته.
التسعير الديناميكي: هل هو جزء من الذكاء؟
يمكن استخدام السعر لتوجيه الطلب، وتشجيع قبول المشاركة، وموازنة العرض، كأن تكون الرحلة الخاصة أغلى والرحلة المشتركة مخفضة. لكن التسعير الديناميكي قد يثير مخاوف تتعلق بالعدالة، والقدرة على تحمل التكلفة، والتمييز السعري. ويجب ألا يكون هدف النظام ملء السيارات بأي ثمن، بل تحسين خدمة النقل مع حماية المستخدمين.
ماذا عن المركبات ذاتية القيادة؟
قد تغيّر اقتصاديات الخدمة لأن تكلفة السائق قد تختفي، لكن ذلك قد يقود أيضًا إلى مزيد من الرحلات الفارغة، وإعادة تموضع أكبر، وطلب مُستحث. ولذلك لا تكون المشاركة بالمركبات الذاتية أقل ازدحامًا تلقائيًا، ويجب أن تقلل الخوارزمية الحركة الفارغة، لا تكلفة التشغيل فقط.
ماذا عن eVTOL والنقل الجوي الحضري؟
يمكن نظريًا مد أفكار الإسناد والجدولة وإدارة الأسطول إلى طائرات eVTOL، لكنها منطقة بحثية وتنظيمية مختلفة كليًا، تشمل المجال الجوي، ومهابط الإقلاع العمودي (Vertiports)، وسلامة البطاريات، والطقس، والاعتماد الجوي. فلا ينبغي عرضها امتدادًا بسيطًا لتطبيق Ride-Pooling نفسه.
إطار عملي لبناء النظام
مراحل البناء
| المرحلة | ما يحدث فيها |
|---|---|
| 1. لا تبدأ بالذكاء الاصطناعي | ابنِ خط أساس من أقرب مركبة ممكنة مع إدراج بسيط، واعرف أداءه |
| 2. أضف القيود | الانتظار، والانحراف، والسعة، ومنطقة الخدمة |
| 3. أضف التحسين | حل أفضل للمطابقة |
| 4. أضف التنبؤ بالطلب | فقط إذا ثبت أن إعادة التوزيع تحتاجه |
| 5. أضف التعلم | مثل GNN/RL إذا لم تعد خطوط الأساس تحقق الهدف |
| 6. اختبر مؤشرات التشغيل | لا خسارة النموذج (Model loss) وحدها |
| 7. اختبر الآثار الخارجية | المسافة المقطوعة، والازدحام، والانبعاثات، والعدالة، والإحلال محل النقل العام |
مثال على معمارية عملية
يمكن قراءة المعمارية العملية مسارين متشابكين. ففي المسار اللحظي يفتح الراكب تطبيقه فيصدر الطلب عبر API طلبات الرحلات، ويتدفق إلى مجرى الطلبات حيث يبدأ العمل الحقيقي: يجمع البحث عن المرشحين المركبات القريبة المتاحة، ويقدّر محرك أزمنة السفر الكلفة الزمنية لكل تركيبة ممكنة، ويبني مولّد الرحلات الممكنة التركيبات التي تحقق القيود، ثم يختار محسّن الإسناد أفضل توزيع، فتُحدَّث خطة المسار وتصل إلى تطبيق السائق لتُنفذ على الطريق.
وبالتوازي يعمل المسار غير اللحظي: تغذي البيانات التاريخية التنبؤ بالطلب الذي يحدد أين ستُحتاج المركبات بعد ساعة، وتحرك سياسة إعادة التوزيع الأسطول استباقيًا وفق هذا التوقع، فتتغير حالة الأسطول نفسها التي يقرأ منها المسار اللحظي مرشحيه. فالمساران يلتقيان عند حالة الأسطول: أحدهما يستهلكها والآخر يشكّلها، ويظهر ذكاء النظام في التنسيق بينهما.
ويمكن إدخال GNN/RL في تمثيل الطلب، أو في سياسة إعادة التوزيع، أو في المطابقة الاستراتيجية، بدل وضع "AI" في كل مكون دون حاجة.
كيف نقرر أن النظام نجح؟
لا يصح القول «حقق النموذج دقة 95%»، فـRide-Pooling ليست مسألة تصنيف. بل يُعرض النجاح بمؤشرات تشغيلية مقارنة بخط الأساس، على نحو:
| المؤشر | صيغة التغير |
|---|---|
| Served requests | +x% |
| Median wait | -y% |
| P95 wait | -z% |
| Mean occupancy | +a |
| Deadhead VKT | -b% |
| Total VKT | -c% |
| Passenger detour | +d min |
| CO₂e/passenger-km | -e% |
ثم تُرفق بها فترة الثقة، وخط الأساس المستخدم، والسيناريو، ومجموعة البيانات، وافتراضات المحاكاة.
تصحيحات يجب الانتباه إليها
| المقولة الشائعة | التصويب |
|---|---|
| "المشكلة NP-hard، إذًا الطرق التقليدية لا تعمل" | غير صحيح؛ صعوبة أسوأ الحالات لا تعني أن كل حالة عملية غير قابلة للحل، والأساليب الاستدلالية والتحسين الحديث قد تكون قوية جدًا |
| "DRL تعمل O(1) بعد التدريب" | غير صحيح كقاعدة؛ الاستدلال يعتمد على حجم المدخلات والمعمارية، وقد يبقى الإسناد أو تحسين المسارات مكلفًا |
| "AI تلغي الازدحام" | مبالغة؛ النتيجة تعتمد على سلوك المستخدمين والسياسات والطلب |
| "Pooling تخفض CO₂ دائمًا" | غير صحيح؛ قد تفشل إذا ارتفعت القيادة الفارغة أو الانحرافات أو الإحلال محل النقل العام |
| "خفض عدد المركبات = خفض الانبعاثات بالنسبة نفسها" | غير صحيح؛ يجب قياس المسافة والسرعة والوقود أو الطاقة والإشغال |
| "نتيجة المحاكاة = نتيجة مدينة حقيقية" | غير صحيح؛ المحاكاة تحتاج معايرة وتحققًا |
الخلاصة
نظام مشاركة الرحلات الذكي ليس مجرد تطبيق يربط عدة ركاب بسيارة، بل نظام تحكم واتخاذ قرار لحظي يدور في حلقة مغلقة لا تتوقف: يرصد حالة الشبكة، ويتنبأ بما سيحدث بعد دقائق، ويولّد الرحلات المشتركة الممكنة ويحل الإسناد الأمثل، فيوجّه المركبات ويعيد توزيع الأسطول استباقيًا، ثم يقيس نتائج ما نفذه ليعود إلى الرصد أذكى مما كان. فالذكاء الحقيقي لا يكمن في خطوة منفردة، بل في سرعة هذه الدورة وجودة القياس الذي يغذيها.
يستطيع الذكاء الاصطناعي المساعدة في توقع الطلب، وتقدير أزمنة السفر، وتمثيل الشبكة عبر GNN، وتعلم سياسات إعادة التوزيع، واختيار القرارات الاستباقية. لكن الفائدة الحقيقية لا تُقاس باسم الخوارزمية، بل بما إذا كان النظام قد رفع إشغال المركبات، وقلل القيادة الفارغة، وخفض إجمالي المسافة المقطوعة، وحافظ على انتظار وانحراف مقبولين، وخدم المناطق بعدالة، وتكامل مع النقل العام بدل سحب ركابه، وخفض الانبعاثات الفعلية لكل راكب-كيلومتر.
ولهذا فالسؤال الأفضل ليس «هل نستخدم MADRL أم GNN؟»، بل:
ما القرار الذي نحتاج تحسينه، وما Baseline الأقوى، وما Metric التي تثبت أن النظام حسّن المدينة لا الخوارزمية فقط؟
المصادر والمراجع
Alonso-Mora et al. — On-demand high-capacity ride-sharing via dynamic trip-vehicle assignment, PNAS
https://pmc.ncbi.nlm.nih.gov/articles/PMC5255617/FHWA — Analysis of Travel Choices and Scenarios for Sharing Rides
https://ops.fhwa.dot.gov/publications/fhwahop21011/ch2.htmErhardt et al. — Do transportation network companies decrease or increase congestion?, Science Advances
https://www.science.org/doi/10.1126/sciadv.aau2670Wenzel et al. — Travel and energy implications of ridesourcing service in Austin, Texas
https://doi.org/10.1016/j.trd.2019.03.005KAPSARC — Impacts of Ride-Hailing on Energy and the Environment: A Systematic Review
https://www.kapsarc.org/research/publications/impacts-of-ride-hailing-on-energy-and-the-environment-a-systematic-review/Eclipse SUMO — Taxi / Demand Responsive Transport documentation
https://sumo.dlr.de/docs/Simulation/Taxi.htmlKe, Yang, Zhu — On Ride-Pooling and Traffic Congestion, Transportation Research Part B
https://doi.org/10.1016/j.trb.2020.10.003
الأسئلة الشائعة حول المقال
ما هي مشاركة الرحلات الديناميكية؟
هي دمج طلبات ركاب مستقلين في مركبة واحدة في الوقت الفعلي إذا كانت مساراتهم وقيود الانتظار والانحراف متوافقة.
ما الفرق بين Ride-Hailing وRide-Pooling؟
Ride-Hailing قد تكون رحلة خاصة لراكب واحد، بينما Ride-Pooling يدمج ركابًا مختلفين داخل المركبة نفسها.
هل Uber أو خدمات النقل بالتطبيق تقلل الازدحام تلقائيًا؟
لا. الدراسات تظهر أن خدمات Ride-Hailing قد تزيد VMT والازدحام بسبب Deadheading وتحول ركاب من النقل العام أو المشي إلى السيارات.
ما Deadheading؟
هي المسافة التي تقطعها مركبة الخدمة دون راكب، مثل القيادة بين إسقاط راكب والتوجه إلى الطلب التالي أو إعادة التموضع.
كيف تتم مطابقة الركاب؟
عبر توليد مجموعات Trips قابلة للتنفيذ، اختبار السعة والانتظار والانحراف، ثم اختيار Assignment بين الرحلات والمركبات وفق Objective محددة.
هل أقرب مركبة هي دائمًا أفضل اختيار؟
لا. قد يكون قرارًا جيدًا لحظيًا لكنه يمنع Pooling أفضل أو يترك منطقة طلب مرتفع دون مركبات لاحقًا.
ما دور GNN؟
تمثل شبكة المدينة والعلاقات بين المناطق أو التقاطعات وتتعلم Features مكانية يمكن استخدامها في Forecasting أو Reinforcement Learning أو قرارات الأسطول.
ما دور Reinforcement Learning؟
يمكن استخدامها لتعلم سياسات متتابعة مثل إعادة توزيع المركبات أو القرارات الاستباقية التي توازن بين المكسب الحالي والطلب المستقبلي.
هل MADRL-GNN أفضل دائمًا؟
لا. هي بنية بحثية محتملة ويجب مقارنتها بطرق Optimization وHeuristics قوية وبنفس البيانات والقيود.
ما أهم مؤشرات تقييم Ride-Pooling؟
وقت الانتظار، الانحراف، رفض الطلبات، متوسط الإشغال، Pooling rate، Deadheading، VKT، VHT، CO₂e لكل راكب-كيلومتر، والعدالة بين المناطق.
النقاش الهندسي والملاحظات (0)
سجّل الدخول للمشاركة في النقاش والرد على التعليقات والإعجاب بها.


